AI 검색 결과에 노출되려면 기계적인 자격 관문을 먼저 통과하고, 그다음 질문이 필요로 하는 형태의 근거를 엔진이 이미 가져다 쓰는 곳에 발행해야 합니다. Google은 그 관문을 분명하게 밝힙니다. 페이지는 색인되어 있어야 하고 Google 검색에서 스니펫과 함께 표시될 자격이 있어야 하며, “추가 기술 요건은 없습니다”.2 관문 뒤에 있는 것도 무작위가 아닙니다. 통제된 프롬프트 602건과 검색 계층 인용 21,143건에서, 공식, 뉴스, 버티컬 출처가 플랫폼에 따라 전체 인용의 79.12%에서 87.52%를 차지했습니다.1
핵심 요약
자격은 기계적이고 무료입니다. 색인되어 있고, 검색 쪽 크롤러가 가져갈 수 있고, 엉뚱한 스니펫 지시문이 없으면 됩니다.
엔진은 역할마다 다른 크롤러를 돌리므로, 학습용 크롤러를 차단해도 검색 색인에서 빠지지 않습니다.
문서를 질문에 맞추십시오. 한 연구의 영향력 대리 지표에서 비교 역할을 한 인용은 평균 0.1524, 참조로만 쓰인 인용은 0.0529였습니다.
계획의 기준으로 삼을 만큼 안정적인 플랫폼 인용 비중은 없습니다. 문헌은 출처 중복이 낮고 실행 간 변동이 크다고 보고합니다.
모니터링은 여러분이 어디에 서 있는지 알려 줍니다. 아래의 레버는 모두 발행이나 아웃리치 행동이므로, 대시보드만으로는 아무것도 움직이지 않습니다.
메커니즘
AI 검색 결과는 실제로 어디에서 옵니까?
색인, 팬아웃, 가져오기에서 오며, 그중 전통적인 SEO처럼 보이는 것은 첫 번째뿐입니다. Google은 자사 AI 기능이 하위 주제와 데이터 소스에 걸쳐 여러 관련 검색을 발행하는 “쿼리 팬아웃 기법을 사용할 수 있다”고 문서에 적고 있으므로, 사람이 입력한 질문이 리트리벌이 보는 쿼리와 같은 경우는 드뭅니다.2 그 밑에 있는 기능들은 “당사의 핵심 검색 순위 및 품질 시스템에 뿌리를 두고 있습니다”.3
두 시스템이 눈에 띄게 갈라지는 곳은 크롤러 계층이고, 이 구분은 추론이 아니라 엔진이 직접 문서화한 것입니다. OpenAI는 학습 데이터용 GPTBot, ChatGPT 검색 기능에 웹사이트를 노출하는 OAI-SearchBot, 그리고 사람이 ChatGPT에 열어 달라고 한 페이지를 위한 ChatGPT-User를 운영하며, 마지막 경우에는 “robots.txt 규칙이 적용되지 않을 수 있습니다”.4 Perplexity도 같은 구조를 문서화하고 있으며, 사용자가 촉발하는 페처는 “일반적으로 robots.txt 규칙을 무시합니다”.5
크롤러 토큰
문서에 적힌 용도
robots.txt
GPTBot
파운데이션 모델 학습에 쓰일 수 있는 콘텐츠
적용됨, 라이선스 선택
OAI-SearchBot
ChatGPT 검색에 웹사이트 노출
적용됨, 차단하면 그 답변에서 빠짐
ChatGPT-User
사람이 요청한 페이지 열기
적용되지 않을 수 있음, 사용자가 시작
PerplexityBot
검색과 링크 연결, 모델 학습 아님
적용됨
Perplexity-User
Perplexity 안에서의 사용자 행동
일반적으로 무시됨
Google-Extended
Google의 다른 곳에서의 AI 학습과 그라운딩
별도 제어, 검색 자격과 무관
robots.txt 한 줄이 지키려던 서피스에서 여러분을 지워 버릴 수 있습니다. 학습용 크롤러를 차단하는 것은 검색에서 아무 대가도 없습니다. 검색 쪽 크롤러를 차단하는 것은 가시성에 관한 결정이며, 팀들은 앞의 것을 하려다 실수로 뒤의 것을 합니다. 어느 토큰이 무엇을 하는지는 크롤러 토큰에 정리되어 있습니다.
공급 쪽
AI 엔진은 어떤 세 가지 출처 유형에서 가져옵니까?
가장 상세한 공개 분석은 그것을 공식, 뉴스, 버티컬로 분류하며, 그 데이터셋에서 이 셋이 모든 플랫폼 인용의 대부분을 차지합니다.1
87.52%ChatGPT 인용 중세 유형 합계
46.35%Google의 공식 출처 비중가장 큰 단일 유형
31.17%ChatGPT의 뉴스 비중두 번째로 큰 유형
21,143검색 계층 인용프롬프트 602건, 플랫폼 3개
출처 유형
ChatGPT
Google
Perplexity
공식
34.22%
46.35%
44.07%
뉴스
31.17%
18.99%
16.07%
버티컬
22.13%
22.00%
18.99%
합계
87.52%
87.34%
79.12%
01
여러분이 가진 페이지
측정된 모든 플랫폼에서 가장 큰 단일 유형이고, 오늘 오후에 바로 발행할 수 있는 유일한 유형입니다. 동시에 공급이 가장 부족한 곳이기도 합니다. 가격, 한도, 이전 경로는 기계가 읽을 수 있는 어디에도 발행되어 있지 않은 경우가 많습니다.
02
여러분이 얻어 내는 보도
그 데이터셋에서 뉴스는 ChatGPT 인용의 31.17%였으므로, 편집 보도는 허영 지표가 아니라 공급선입니다. 작업 단위는 기자가 검증할 수 있는 것입니다. 자체 데이터, 벤치마크, 무료 도구 같은 것입니다.
03
여러분을 비교하는 문서
총정리 글, 카테고리 해설, 커뮤니티 스레드는 이름이 붙은 여러 선택지를 한 번에 설명하며, 그것이 후보 목록형 질문이 필요로 하는 형태입니다. 구조적인 이유는 서드파티 페이지에서 다룹니다.
백분율보다 라벨을 먼저 읽으십시오. 이것은 한 기간에 수집된 연구 자체의 분류이고, 표에 커뮤니티 플랫폼이 별도 행으로 나와 있지 않으므로 “버티컬”은 “포럼”과 같은 말이 아닙니다.1 그 단서를 달고도 남는 것은 순서입니다. 어디서나 여러분 자신의 사이트가 가장 큰 유형이고, 얻어 낸 보도가 그다음이며, 다른 누군가가 여러분을 비교하는 문서가 나머지를 채웁니다. 생산 라인이 셋이고 리드 타임도 셋이며, 그중 하나만 돌리는 프로그램은 그 유형의 크기에서 막힙니다.
레버의 문제
Reddit은 여전히 노출 효과가 가장 큰 곳입니까?
좁은 한 부류의 질문에서는 그렇습니다. 그리고 이유는 도메인 권위가 아니라 문서의 형태입니다. “X에 사람들이 실제로 뭘 쓰나” 같은 형태의 질문은 겪어 본 이유가 붙은, 이름 있는 선택지 여럿을 요구합니다. 스무 명이 경험으로 그 질문에 답한 스레드는 카테고리에 관한 비교 형태의 근거입니다. 여러분의 제품 페이지는 선택지 하나에 관한 참조 형태의 근거입니다.
인용 표도 같은 방향입니다. 비교 역할의 인용은 1,719건이고 영향력 대리 지표에서 평균 0.1524로, 정의의 0.1531 다음이며 참조로만 쓰인 인용의 0.0529보다 약 세 배 높습니다. 페이지 단위로는 비교 내용을 담은 문서의 평균이 0.1389, 담지 않은 문서는 0.0894였고, +55.28%로 표기됩니다. 저자들은 영향력이 높은 페이지를 “정의, 수치 사실, 비교, 절차 단계 같은 추출 가능한 근거가 더 풍부하다”고 묘사합니다.1
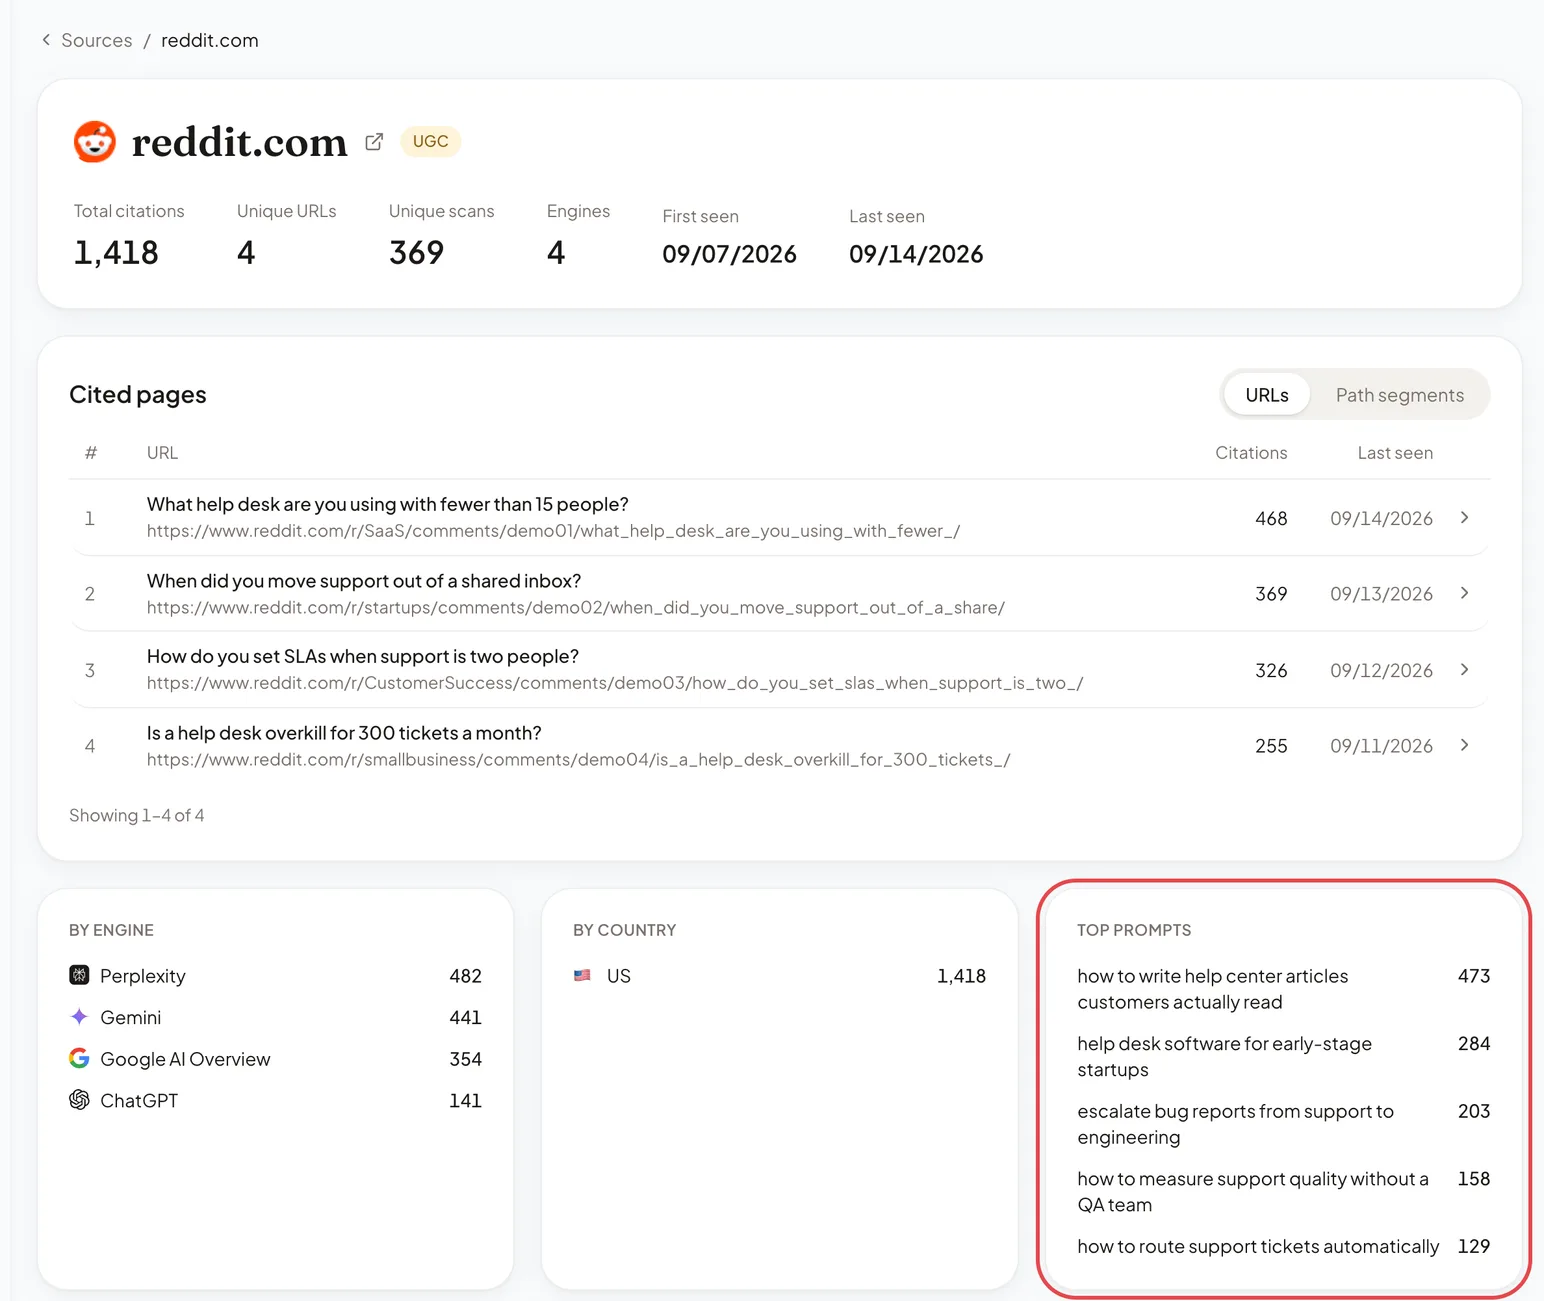
그래서 작업 단위는 도메인이 아니라 스레드와 질문이며, 어디에든 게시하기 전에 그 둘을 찾아야 합니다. Bavior에서 Sources를 통해 reddit.com을 여십시오. Cited pages는 답변이 인용한 구체적인 스레드를, Top prompts는 엔진이 그 스레드를 인용하게 만든 구매 질문을 보여 줍니다. 여러분이 신경 쓰는 질문에 답하는 스레드에 참여하고, 사이트의 나머지는 건너뛰십시오.
데모 워크스페이스의 샘플 데이터입니다. 스레드 제목은 예시이며 실제 Reddit 게시물이 아닙니다. 빨간 상자는 인용 뒤에 있는 질문인 Top prompts를 표시합니다. 수치는 데모 프롬프트 세트 하나에서 나온 것이며 플랫폼 비중이 아닙니다.
레버가 멈추는 곳은 경쟁이고, 이것도 측정되었습니다. C-SEO Bench는 “C-SEO 채택자 수를 늘릴수록 전체 이득이 줄어든다”는 것을 발견하고 이 문제를 혼잡한 제로섬 게임이라고 불렀습니다.8 커뮤니티 플랫폼에는 그 성질에 더해 모더레이터가 있습니다. 세 회사가 할 때 통하던 방법은 삼백 회사가 하면 그것을 막는 규칙이 생깁니다. 플랫폼이 요구하는 곳에서는 상업적 관계를 밝히고, 나머지는 스레드 선택을 참고하십시오.
여러분이 본 적 있는 그 백분율에 대해
ChatGPT 인용에서 Reddit의 비중이 40% 가깝다는 수치가 끊임없이 돌아다니지만, 이를 뒷받침하는 동료 심사 연구는 없습니다. 존재하는 측정은 서로 다른 분모를 쓰는 상업 패널이고, 저희가 2026년 9월 12일에 확인한 측정들은 누구든 측정하려는 효과보다 더 크게 서로 엇갈렸습니다. 문헌은 그것이 예상된 일인 이유를 설명합니다. 엔진마다 출처 다양성과 안정성이 크게 다르고,6 비판적 서베이는 상업 감사 전반에서 출처 중복이 낮고 실행 간 변동이 크다고 기록합니다.7 플랫폼 비중은 패널 하나의 날짜가 붙은 스냅숏이며, 어떤 계획도 그것에 기대서는 안 됩니다.
커뮤니티 플랫폼에서 할 가치가 있는 일
여러분이 신경 쓰는 질문에 대해 이미 상위에 오르는 스레드에서, 운영 경험을 바탕으로 답하십시오
빠져 있는 숫자, 가격, 한도, 이전 경로를 발행해 스레드를 인용할 만한 곳으로 만드십시오
서브레딧이나 플랫폼이 요구하는 곳에서는 상업적 관계를 밝히십시오
할 가치가 없는 일
참여한 적 없는 스레드에서 언급을 사는 것
비교 문단 하나를 여러 서브레딧에 붙여 넣는 것. C-SEO Bench가 측정한 혼잡 효과입니다
한 플랫폼의 인용 비중을 목표로 잡는 것. 여러분이 통제할 수도, 재현할 수도 없는 숫자입니다
다른 공급선
커뮤니티 스레드 말고 답변을 움직이는 것은 무엇입니까?
자격이 먼저입니다. 예 아니면 아니요이기 때문이고, 함정도 같은 문서 안에 있습니다. 스니펫 제어인 nosnippet, data-nosnippet, max-snippet은 AI 기능이 여러분의 페이지에서 무엇을 보여 줄 수 있는지도 좌우합니다.2 몇 년 전 페이월을 보호하려고 넣은 지시문 하나가 여러분이 끝내 나타나지 않는 이유일 수 있습니다.
팀들이 다음으로 과잉 투자하는 것은 구조화 데이터이고, Google은 드물게 단호합니다. “생성형 AI 검색에 구조화 데이터는 필요하지 않으며, 추가해야 하는 특별한 schema.org 마크업도 없습니다”.3 마크업은 그것을 소비하는 기능을 위한 파싱 위생으로서 제 몫을 합니다. 답변이 여러분을 인용하느냐를 움직이는 레버는 아니므로, 예산도 그렇게 잡으십시오.
인용을 따내려고 하는 재작성이 여기서 가장 흔한 실패이고, 두 번 측정되었습니다. C-SEO Bench는 대부분의 대화형 SEO 방법이 “대체로 효과가 없을 뿐 아니라 문서 순위에 부정적 영향을 주는 경우도 잦다”고 보고합니다.8 연구 45건을 다룬 서베이도 같은 곳에 이릅니다. 관련성과 컨텍스트 위치가 가장 재현성 높은 레버이고, 인용을 노린 재작성은 리트리벌을 해칠 수 있습니다.7 인용하기 좋은 답으로 다시 쓴 페이지가 리트리벌 풀에서 떨어져 나가면, 유일하게 중요했던 판을 잃은 것입니다.
무엇보다 먼저 자격을 고치십시오
색인되어 있고, 검색 쪽 토큰마다 가져갈 수 있고, 엉뚱한 스니펫 지시문이 없어야 합니다. 전체 순서는 기술 체크리스트에 있습니다.
형용사가 아니라 근거를 발행하십시오
정의, 숫자, 비교, 절차가 가장 높은 점수를 받았습니다. 페이지에서 떼어 내도 살아남는 문단이, 제자리에서만 잘 읽히는 섹션보다 낫습니다.
낯선 사람이 검증할 수 있는 언급을 얻으십시오
자체 데이터, 공개 벤치마크, 무료 도구는 기자에게 인용할 거리를 주고, 엔진에게는 여러분의 이름을 부르는 두 번째 문서를 줍니다.
이미 여러분을 설명하는 페이지를 바로잡으십시오
여러분의 옛 가격이 실린 총정리 글은 그 오류를 답변에 계속 흘려 넣습니다. 그것을 바로잡는 일이 가장 빨리 돌아옵니다. 여러분의 카테고리가 인용되는 곳에서 시작하십시오.
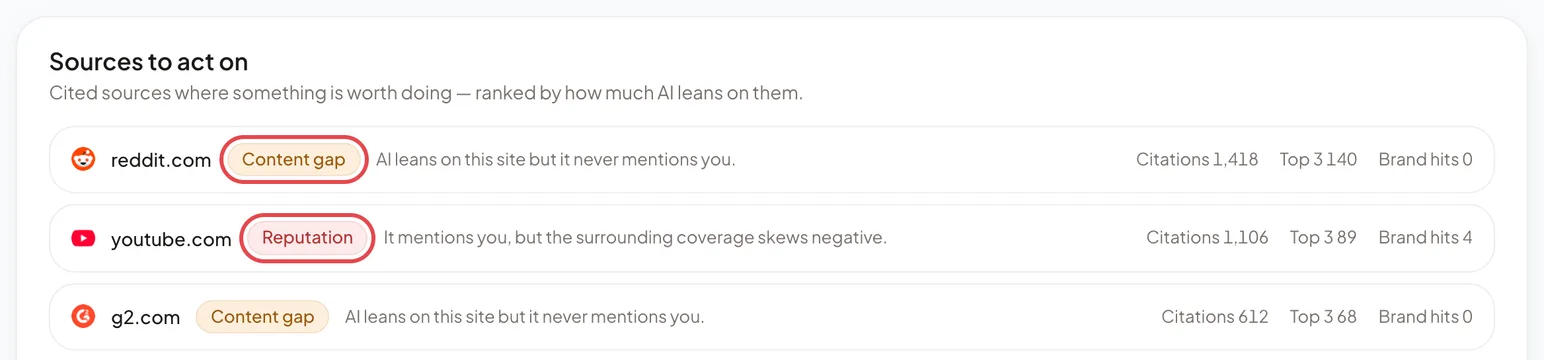
마지막 단계를 실행하려면 Bavior에서 Sources를 열고 Sources to act on의 각 행에 붙은 라벨을 읽으십시오. 같은 인용 출처라도 정반대의 일을 요구할 수 있기 때문입니다. Content gap은 답변이 그 출처를 인용하지만 그 출처가 여러분을 전혀 언급하지 않는다는 뜻이며, 위의 공급선들이 맡을 일입니다. Reputation은 그 출처가 여러분을 언급하되 부정적으로 기운 보도 속에서 언급한다는 뜻이며, 이미 여러분을 설명하는 페이지를 바로잡는 일은 그 행에서 시작합니다.
데모 워크스페이스의 샘플 데이터입니다. 빨간 상자: 두 가지 행동 라벨.
모니터링 대 실행
왜 대부분의 AI 가시성 도구는 문제의 절반만 풉니까?
측정과 공급은 서로 다른 일이고, 깔끔하게 차트로 바뀌는 것은 그중 하나뿐이기 때문입니다. 모니터링 제품은 프롬프트 세트를 돌리고, 각 답변이 어떤 출처를 인용했는지 기록하고, 추세를 그립니다. 이 일은 장식이 아니라 필요한 일입니다. 비판적 서베이가 상업 감사를 요약한 결과는 낮은 출처 중복, 큰 실행 간 변동, 지속적인 충실도 격차이고,7 다섯 개 생성형 시스템을 Google 오가닉 검색과 비교한 ACL 연구는 “내부 지식과 외부 지식에 대한 의존도, 출처 다양성, 안정성에서 엔진 간에 상당한 차이”를 보고합니다.6 반복 실행 없이는 변화와 노이즈를 가를 수 없습니다.
차트가 할 수 없는 것은 발행입니다. 이 페이지의 모든 레버는 결국 누군가 쓰는 문서, 누군가 지우는 지시문, 누군가 답하는 스레드로 귀결됩니다. 서베이는 한 문장으로 상한을 긋습니다. 이미 리트리벌된 콘텐츠는 자신의 인용이나 사용을 인과적으로 바꿀 수 있지만, 검토된 어떤 기법도 오가닉 발견 가능성에 대해 안정적이고 종단적이며 플랫폼을 가로지르는 인과 효과를 보여 주지 않습니다.7 문서에 손을 대고, 반복 실행으로 측정하고, 측정 자체가 시끄러우리라고 예상하십시오.
이 카테고리의 두 절반을 가르는 질문이 하나 있습니다. 도구를 일주일 쓴 뒤, 대시보드 밖에서 무엇이 바뀌었습니까? 답이 프롬프트 목록과 알림 요약이라면 그 도구는 보고를 해결한 것이고, 보고는 정말로 어렵고 돈을 낼 가치가 있습니다. 다만 여러분을 인용되게 만드는 절반은 아닙니다.
30일 계획
30일 AI 가시성 계획은 어떤 모습입니까?
4주 동안 주마다 한 가지 일, 그리고 그것이 자리 잡았음을 증명하는 확인 하나. 예산은 필요 없고, 인용은 약속하지 않습니다.
베이스라인: 실제 구매 질문 20개에서 30개, 각 3회 실행, 인용된 URL 전부 기록.
시트 하나, 실행 60회에서 90회, 여러분이 가진 페이지, 여러분을 설명하는 페이지, 여러분을 무시하는 페이지로 분류.
15일차부터 21일차
베이스라인이 찾아낸 빈틈 채우기: 비교, 가격과 한도, 절차.
페이지 세 개 공개, 각각 기록된 질문 하나에 단독으로 답하는 문단 포함.
22일차부터 30일차
사이트 밖 작업과 재측정: 스레드 두 개에 답하고, 여러분을 잘못 적은 페이지 하나를 바로잡고, 세트를 다시 실행.
인용 URL 목록의 차이. 증명이 아니라 방향으로 읽음.
이 계획의 정직한 한계
30일은 자격을 고치고, 베이스라인을 만들고, 문서 세 개를 내놓기에 충분합니다. 인과를 증명하기에는 충분하지 않으며, 아직 어떤 단일 기법도 지속적인 플랫폼 간 효과를 보여 주지 못했습니다.7 기대할 것은 깨끗한 기계적 점검, 반복 가능한 측정, 그리고 전에는 없던 공급선입니다. 오르기만 하는 숫자는 기대하지 마십시오. 출처 구성은 여러분의 일정이 아니라 엔진의 일정대로 움직입니다.
제품이 쓸모 있는 자리와 그렇지 않은 자리
위의 첫 2주는 일부러 무료이고 수작업입니다. 무너지는 것은 5주차입니다. 세트를 일정대로 다시 돌려야 하고, 답할 가치가 있는 스레드가 누구도 다 읽지 못할 속도로 나타날 때입니다. Bavior는 고정된 프롬프트 세트를 여러 엔진에 일정대로 다시 실행하고 각 답변이 어떤 출처를 인용했는지 기록하며, 인용된 출처가 진행 중인 토론이면 여러분이 관리하는 계정으로 여러분의 목소리에 맞춘 답글 초안을 씁니다. Bavior의 오래된 계정이든 여러분 자신의 계정이든, 여러분의 승인 없이는 아무것도 게시되지 않습니다. 게재 자리를 사거나, 등재를 협상하거나, 어떤 엔진이 여러분을 인용하게 만들 수는 없습니다. 플랜은 월 $99부터이며, 대행사 리테이너는 월 $3,000에서 $20,000입니다.¹
출처, 모두 2026년 9월 12일 확인
Zhang Kai, He Xinyue, Yao Jingang, “From Citation Selection to Citation Absorption”, 2026년 4월 28일(v2는 2026년 4월 29일), arXiv:2604.25707(서술적 프리프린트, 공개 geo-citation-lab 데이터셋); 프롬프트 602건, 검색 계층 인용 21,143건, 가져온 페이지 18,151개; 출처 유형, 의미 역할, 근거 장르 표: arxiv.org/abs/2604.25707
Kirsten 외, “Characterizing Web Search in The Age of Generative AI”, Findings of ACL 2026, pp. 10827–10848; 세 제공사의 생성형 시스템 다섯 개를 Google 오가닉과 비교: aclanthology.org/2026.findings-acl.526
Olivier Martinez, “Optimizing Visibility in Generative Engines: A Critical Survey (2023–2026)”, 2026년 7월 15일, arXiv:2607.14035(서베이 프리프린트); 연구 45건, 2023년 11월부터 2026년 7월까지: arxiv.org/abs/2607.14035
Puerto 외, “C-SEO Bench: Does Conversational SEO Work?”, NeurIPS 2025 Datasets & Benchmarks Track, arXiv:2506.11097(v1 2025년 6월 6일, v3 2025년 10월 20일); 방법 열 가지, 과제 두 가지, 과제별 도메인 세 개: arxiv.org/abs/2506.11097
자격 관련 변경은 재크롤링만큼 빨리 반영되며, 대개 며칠입니다. 인용되는 것은 더 느리고 더 시끄럽습니다. 같은 질문이라도 실행마다 답변이 달라지기 때문입니다. 기계적인 수정은 1주 안에, 베이스라인은 2주 안에, 그리고 고정된 프롬프트 세트를 최소 세 번 반복 실행한 뒤에야 읽을 만한 방향이 나온다고 계획하십시오.
AI 검색 결과에 노출되려면 schema 마크업이 필요합니까?
아닙니다. Google 자체 가이드는 생성형 AI 검색에 구조화 데이터가 필요하지 않고 추가해야 할 특별한 schema.org 마크업도 없다고 밝힙니다. 마크업은 그것을 소비하는 검색 기능에는 여전히 쓸모가 있으니, 인용을 움직이는 레버가 아니라 적은 예산의 파싱 위생으로 다루십시오.
GPTBot을 차단하면 ChatGPT 검색 결과에서 빠집니까?
아닙니다. OpenAI는 역할마다 다른 토큰을 문서화합니다. GPTBot은 파운데이션 모델 학습에 쓰일 수 있는 콘텐츠를 크롤링하고, ChatGPT 검색 기능에 사이트를 노출하는 것은 OAI-SearchBot입니다. 앞의 것을 차단하는 것은 라이선스 선택입니다. 여러분을 그 답변에서 빼는 것은 뒤의 것을 차단하는 일입니다.
AI 엔진이 제 브랜드를 인용하도록 보장하는 도구가 있습니까?
없습니다. 그렇다고 주장하는 벤더는 아무도 입증하지 못한 것을 설명하고 있습니다. 이 분야에 대해 발표된 서베이는 검토된 어떤 기법도 발견 가능성에 대해 안정적이고 플랫폼을 가로지르는 인과 효과를 보여 주지 않는다고 보고합니다. 돈으로 살 수 있는 것은 더 빠른 측정, 그리고 답변이 끌어다 쓸 수 있는 문서를 더 빨리 공급하는 일입니다.
Bavior 편집팀
Reddit 마케팅과 AI 검색 가시성에 관한 Bavior의 콘텐츠를 조사하고 관리하는 팀입니다. 본문의 모든 수치에는 출처와 확인 날짜를 명시했으며, 제휴 링크는 사용하지 않습니다.