ChatGPT가 어떤 페이지를 인용하는 것은 서로 별개인 두 가지 일이 모두 일어났을 때입니다. 검색 계층이 여러분을 대신해 발행한 쿼리에서 그 페이지를 리트리벌했고, 작성 중인 답변이 그 페이지가 떼어 쓸 수 있는 형태로 담고 있던 근거를 필요로 했습니다. 대부분의 조언은 이 둘을 하나로 뭉개며, 그래서 여러분이 가진 페이지를 다시 써도 좀처럼 아무것도 움직이지 않습니다. 통제된 프롬프트 602건과 검색 계층 인용 21,143건에서, ChatGPT는 답변당 인용한 출처 수가 Google이나 Perplexity보다 적었지만 가져온 페이지들 사이의 평균 인용 영향력은 상당히 더 높았습니다.1
핵심 요약
첫 번째 관문은 접근이고, robots.txt에서 정해집니다. OAI-SearchBot을 거부한 사이트는 “ChatGPT 검색 답변에 표시되지 않습니다”.
두 번째 관문은 흡수입니다. ChatGPT는 답변당 인용 자리를 Perplexity나 Google보다 적게 주므로, 한 자리 한 자리가 더 귀합니다.
영향력이 높은 페이지는 측정해 보면 더 길고, 더 구조화되어 있으며, 정의, 사실, 비교, 절차가 풍부합니다.
ChatGPT 인용에서 Reddit이 차지하는 비중은 열한 달 사이에 16.8%, 12.6%, 3.11%, 0.52%로 발표되었고, 분모는 모두 달랐습니다.
여러분이 가진 페이지를 고치는 것은 검증할 때마다 효과가 확인되지 않습니다. 54개 사례 중 통계적으로 유의한 것은 세 건입니다.
두 개의 관문
ChatGPT는 왜 어떤 출처는 인용하고 어떤 출처는 무시합니까?
두 시스템이 모두 허락해야 하고, 둘이 판단하는 대상이 다르기 때문입니다. OpenAI는 역할마다 별도의 크롤러를 운영하고, 검색을 관할하는 것은 그중 하나뿐입니다. “OAI-SearchBot을 거부한 사이트는 ChatGPT 검색 답변에 표시되지 않지만, 내비게이션 링크로는 여전히 나타날 수 있습니다.” 같은 페이지는 “ChatGPT-User는 콘텐츠가 검색에 나타날 수 있는지를 판단하는 데 쓰이지 않는다”고 덧붙이며, GPTBot은 모델 학습용입니다.5 첫 번째 관문은 예 아니면 아니요이고, robots.txt에서 정해집니다.
두 번째 관문은 성격이 다릅니다. 가장 큰 공개 인용 데이터셋 뒤에 있는 프레임워크는 문제를 둘로 나눕니다. 플랫폼이 출처를 고르는 인용 선택, 그리고 인용된 페이지가 언어, 근거, 구조를 실제로 보태는 인용 흡수입니다. 핵심 발견은 이렇습니다. “Perplexity와 Google은 평균적으로 더 많은 출처를 인용하는 반면, ChatGPT는 더 적은 출처를 인용하지만 가져온 페이지들 사이에서 평균 인용 영향력이 상당히 더 높다.”1 출처 목록이 짧다는 것은 몇 안 되는 자리를 두고 경쟁한다는 뜻이고, 가져와졌다고 해서 인용된 것은 아닙니다.
아무도 합의하지 못하는 숫자
Reddit이 정말 ChatGPT 인용을 지배합니까?
공개된 측정 네 건은 열한 달 안에 ChatGPT 인용에서 Reddit이 차지하는 비중을 16.8%, 12.6%, 3.11%, 0.52%로 제시합니다. 나누는 대상이 서로 다릅니다.
오른쪽 열보다 가운데 열을 먼저 읽으십시오. 인용 상위 50개 도메인 중의 비중은 세기 전에 롱테일을 버리므로 언제나 크게 보입니다. Reddit 링크가 포함된 답변의 비중은 인용이 아니라 답변을 셉니다. 40억 건이 넘는 코퍼스에서 모든 엔진의 모든 인용 중 비중은 가장 엄격한 분모이고, 가장 작은 숫자를 돌려줍니다.10
아래 두 행은 분모 논쟁이 아니라 변화입니다. Promptwatch는 2026년 7월 18일부터 8월 7일까지 ChatGPT 인용에서 Reddit을 3.83%로, 이어 8월 14일부터 17일까지 0.52%로 기록했습니다. 상대 감소율 86.4%이며, Search Engine Land와 Search Engine Journal이 8월 19일에 보도했습니다.11 원인은 밝혀지지 않았습니다. ChatGPT는 8월 8일에 백그라운드 검색 방식을 바꿨지만 인용은 8월 14일까지 유지되었고, 해당 벤더는 이 결과를 잠정적이라고 부릅니다.
그러니 정직한 주장은 “Reddit이 AI 인용을 지배한다”보다 좁습니다. 위의 모든 측정에서 Reddit은 가장 많이 인용되는 커뮤니티 도메인 중 하나이고, 어느 한 엔진에서의 비중은 버전 사이에 몇 배씩 움직입니다. 레버는 애초에 그 백분율이 아니었습니다. “이런 일에 사람들이 실제로 뭘 쓰나”라는 질문에 가장 잘 답하는 것은 여러 사람이 이미 선택지를 비교해 둔 문서이고, 그것은 대개 스레드입니다. 스레드 선택과 서드파티 페이지를 참고하십시오.
문서의 형태
ChatGPT가 인용할 수 있는 문단은 어떤 모습입니까?
데이터셋이 그 윤곽을 직접 묘사합니다. “영향력이 높은 페이지는 더 길고, 더 구조화되어 있고, 의미적으로 정렬되어 있으며, 정의, 수치 사실, 비교, 절차 단계 같은 추출 가능한 근거가 더 풍부한 경향이 있다.”1 이는 이미 인용된 페이지를, 가져온 페이지 18,151개에서 측정해 묘사한 것이며, 저자들은 이 논문을 서술적 연구로 규정합니다. 정의를 추가하면 인용이 일어난다는 증거가 아닙니다.
여기서 끌어낼 수 있는 것은 쓸 만한 형태 하나입니다. 한 질문에는 한곳에서 답하고, 숫자에는 날짜와 분모를 붙이고, 주장이 더는 성립하지 않는 경계를 밝히십시오. 나머지는 Google이 배제합니다. 이런 기능에 나타나기 위해 새로운 기계 판독용 파일이나 AI 텍스트 파일, 마크업을 만들 필요가 없으며, 색인되어 스니펫 자격을 갖추는 것 외에 “추가 기술 요건은 없다”고 밝힙니다.6인용될 만한 문단은 그 형식을 하나씩 짚고, 길이, schema, llms.txt는 파일 기반 전술의 값어치를 따집니다.
방법
ChatGPT가 이미 인용하는 스레드에서 언급을 얻으려면 어떻게 해야 합니까?
다섯 단계를 이 순서대로 밟습니다. 거의 모두가 3단계부터 시작하고, 그것도 한 번도 인용된 적 없는 스레드에서 시작합니다.
1
서브레딧 규모가 아니라 인용된 URL에서 시작하십시오
구매자가 실제로 입력할 질문 열 개를 적고, 신경 쓰는 모든 엔진에서 각각 돌린 뒤, 답변이 인용한 URL을 모두 기록하십시오. 보통 열다섯 개 안팎인 이 목록이 여러분의 작업 세트입니다.
2
서브레딧보다 스레드를 먼저 읽으십시오
세 가지를 순서대로 확인하십시오. 스레드가 아직 답글을 받고 있는지, 그 질문이 여러분이 구체적인 무언가로 답할 수 있는 질문인지, 그리고 그 서브레딧이 상업적 이해관계가 있는 사람의 답글을 허용하는지입니다.
3
실제로 나온 질문에 답하십시오
인용되는 답글에는 제약, 숫자, 경계가 들어 있습니다. 무엇을 측정했는지, 무엇을 대상으로 했는지, 어디서부터 성립하지 않는지입니다. 포지셔닝처럼 읽히는 버전은 모더레이터가 먼저 지웁니다.
4
커뮤니티가 요구하는 곳에서는 관계를 밝히십시오
서브레딧이나 플랫폼이 상업적 관계의 공개를 요구하는 곳에서는 공개가 필수이며, 청중의 일부가 리트리벌 시스템이라고 해서 그 의무가 약해지지는 않습니다.
5
같은 프롬프트를 다시 돌리고 세트의 움직임을 지켜보십시오
인용 세트는 안정적이지 않으므로, 3월에 답변을 떠받치던 스레드가 9월에는 아무것도 떠받치지 않을 수 있습니다. 고정된 프롬프트 세트를 일정에 따라 다시 돌리고, 빠져나간 스레드에는 더 이상 공을 들이지 마십시오.
건너뛰어지는 것은 1단계이고, 그것을 건너뛰는 것이 여기서 가장 비싼 실수입니다. 규모로 커뮤니티를 고르면 인기 순위가 나옵니다. 엔진이 리트리벌하는 스레드는 질문과 맞물리는지로 선택되며, 두 목록은 누구의 예상보다도 훨씬 적게 겹칩니다. 한 번도 인용된 적 없는 스레드에 쓴 유용한 답글은 호감은 사도 인용은 사지 못하고, 실패했다는 사실을 알려 주는 것도 없습니다.
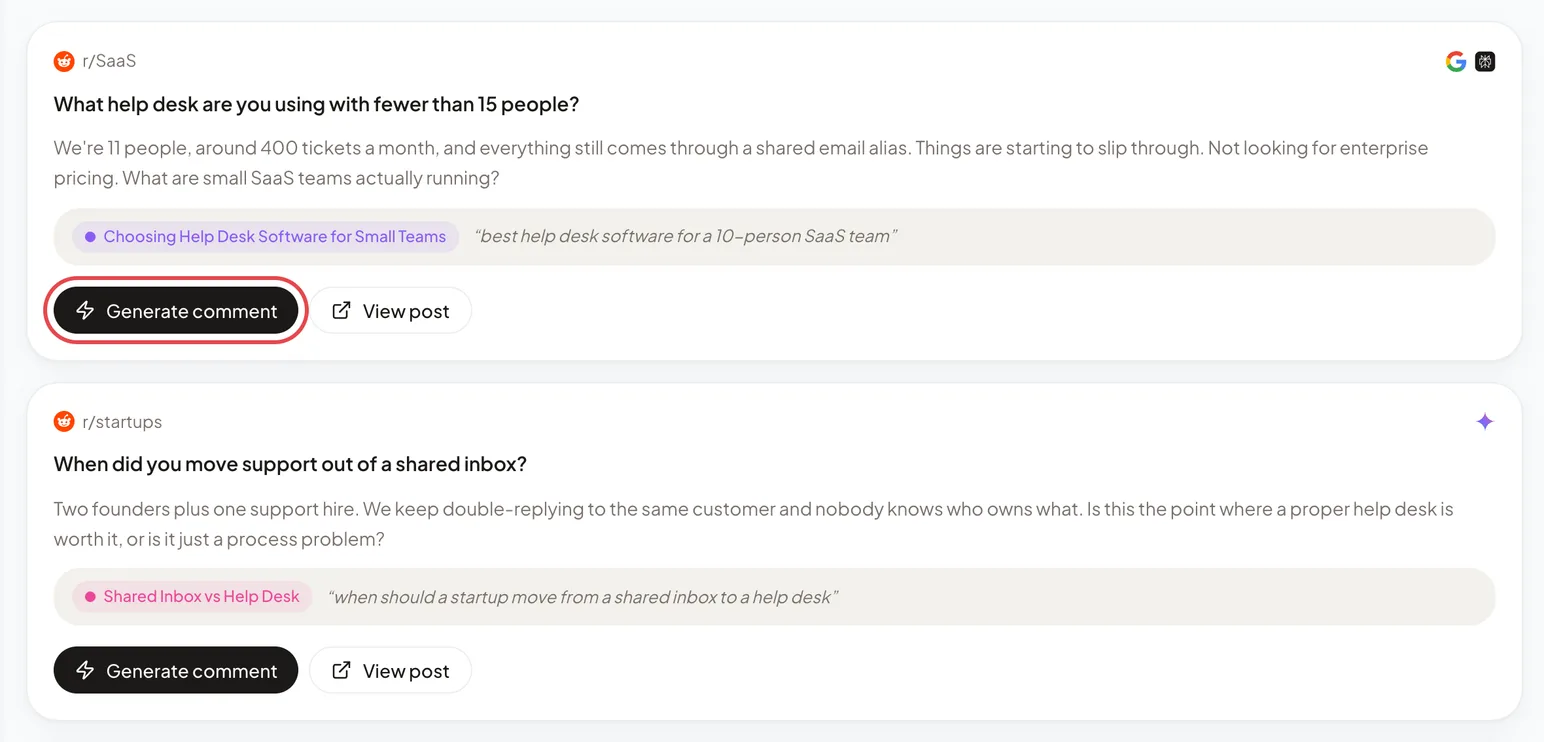
1단계와 2단계는 프롬프트와 각 답변이 인용한 URL을 적은 스프레드시트로 손으로 할 수 있습니다. Bavior는 그 스레드를 찾는 일과 답글 초안 작성, 승인을 하나의 대기열에 담습니다. Action Opportunities를 여십시오. 카드 하나하나가 AI 엔진이 이미 인용하는 스레드이며, 서브레딧과 그 스레드를 끌어올린 주제와 프롬프트가 함께 표시됩니다. Generate comment를 누르기 전에 View post로 2단계 확인을 하십시오.
데모 워크스페이스의 샘플 데이터입니다. 스레드 제목은 예시이며 실제 Reddit 게시물이 아닙니다. 빨간 상자는 Generate comment를 표시합니다. 이 버튼은 게시물이 아니라 여러분이 검토할 초안을 만듭니다.
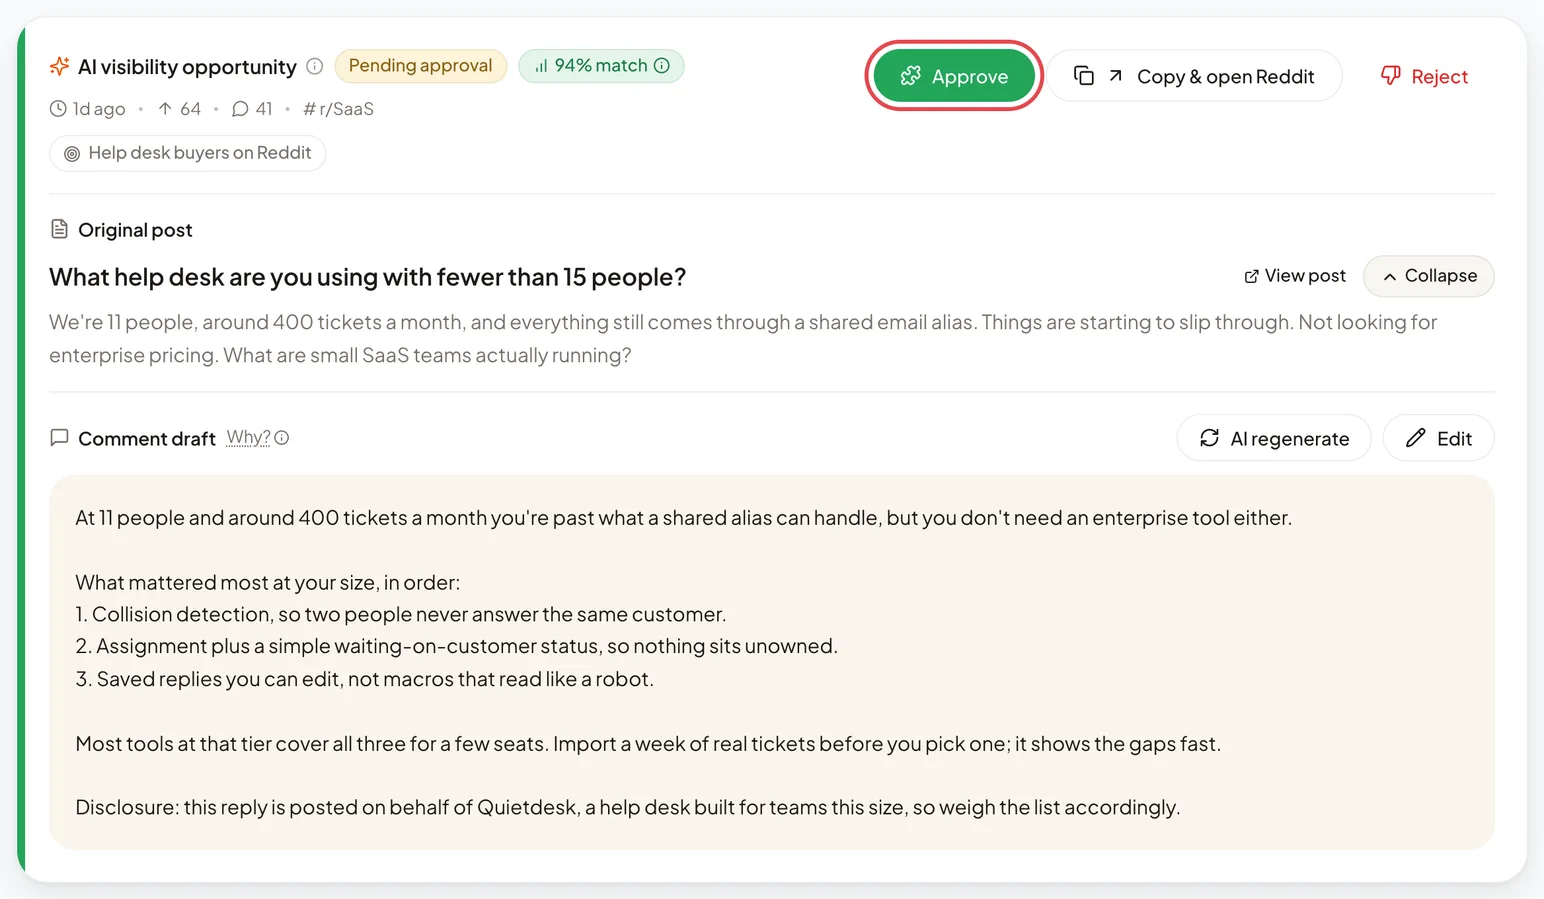
초안은 Pending approval에서 기다립니다. 각각을 3단계와 4단계에 비추어 확인하십시오. 작성자가 제시한 조건 안에서 답하고 있습니까? 서브레딧이 요구하는 대로 누구를 위해 게시되는지 밝히고 있습니까? 둘 다 충족될 때까지 Edit으로 고치십시오. Approve를 누르면 Bavior가 제공하는 계정으로 사람 운영자가 게시합니다. Copy & open Reddit은 여러분 자신의 계정으로 게시할 때 씁니다.
데모 워크스페이스의 샘플 데이터입니다. 스레드 제목은 예시이며 실제 Reddit 게시물이 아닙니다. 이 초안은 위 첫 번째 카드와 같은 스레드에 대한 것입니다. 빨간 상자는 Approve를 표시하며, 이것 없이는 Bavior가 아무것도 게시하지 않습니다.
정직하게 짚어 둘 기대가 하나 있습니다. 이 조언의 대중적인 버전이 그것을 전제하기 때문입니다. 업보트를 받은 답글이 인용이 되는 것은 아닙니다. 그 답글은 여러분이 신경 쓰는 쿼리에서 리트리벌될 수도 있고 안 될 수도 있는 스레드의 일부가 될 뿐이며, 엔진이 그 쿼리를 발행할지는 여러분이 정할 수 없습니다. 이 글이 확인할 수 있었던 연구 중에 업보트 수, 댓글 깊이, 계정 나이를 인용 선택의 입력으로 측정한 것은 없습니다.
쿼리에서 인용까지
질문과 인용 사이에서는 무슨 일이 일어납니까?
네 가지이고, 여러분이 통제하는 것은 한 가지 반입니다. 먼저 질문이 분해되어 여러 번 검색됩니다. Google은 “하위 주제와 데이터 소스에 걸쳐 여러 관련 검색을 발행하는” 쿼리 팬아웃 기법을 문서화하고 있으며, 페이지가 뒷받침 링크로 나타나려면 색인되어 스니펫 자격이 있어야 하고 “추가 기술 요건은 없다”고 밝힙니다.6 여기서 여러분의 몫은 도달 가능한지 여부뿐이고, 그것이 리트리벌의 전부입니다. 하위 쿼리는 엔진이 쓰며, 그것이 얼마나 멀리 벗어나는지는 쿼리 팬아웃이 다룹니다.
둘째, 그 결과가 후보 집합으로 추려지고 다시 정렬됩니다. 이 단계는 근거가 가장 강하고 꼼수가 들어갈 여지가 가장 적습니다. 이 분야 문헌에 대한 유일한 비판적 서베이는 “주제 관련성과 컨텍스트 위치”를 가장 재현성 높은 레버로 꼽고, “일반적인 휴리스틱은 잘 옮겨 가지 않는다”고 경고합니다.3선택과 재순위화를 참고하십시오.
셋째, 답변이 작성된 다음에 귀속이 붙습니다. 그래서 페이지는 이름이 불리지 않고도 답변을 형성할 수 있습니다. 종합과 귀속, 그리고 5단계 파이프라인을 참고하십시오. 넷째, 이 중 어느 것도 가만히 있지 않습니다. 오가닉 검색과 다섯 개 생성형 시스템을 비교한 ACL 2026 연구는 출력이 “시간과 실행에 따라 달라진다”고 보고합니다.4
검증했고 효과 없음
어떤 변경이 검증을 거쳐 효과가 없다고 확인되었습니까?
대부분 가장 팔기 쉬운 것들입니다. NeurIPS 2025 Datasets and Benchmarks 트랙에 실린 C-SEO Bench는 쿼리 1,915건과 16,000건이 넘는 문서에서 화이트햇 대화형 SEO 방법들을 검증했습니다. 결과는 이렇습니다. “54개 사례 중 순위 개선이 통계적으로 유의미한 경우는 세 건뿐이었다.”2 GEO 리테이너가 사 주는 일의 대부분을 제대로 측정했더니 평평하게 나온 것입니다.
2023년부터 2026년까지를 다룬 서베이는 다른 방향에서 같은 곳에 도착합니다. 이미 리트리벌된 콘텐츠는 자신이 인용되는지를 인과적으로 바꿀 수 있습니다. 그리고 상한이 있습니다. “검토된 어떤 기법도 오가닉 발견 가능성이나 후속 행동에 대해 안정적이고 종단적이며 플랫폼을 가로지르는 인과 효과를 보여 주지 않는다”.3 이미 후보 집합에 있는 문서를 고치는 것은 의미가 있을 수 있습니다. 문서를 그 집합에 넣는 일에서 공개된 근거가 바닥납니다. 효과가 확인되지 않는 전술과 리트리벌을 해치는 재작성을 참고하십시오.
Google도 스스로 비슷한 말을 합니다. “Google 검색의 생성형 AI 기능은 당사의 핵심 검색 순위 및 품질 시스템에 뿌리를 두고 있다”.7 따로 난 문은 없습니다. 그러니 여러분이 가진 페이지를 다시 고치는 데는 덜 쓰고, 여러분 카테고리에 대해 어떤 문서가 존재하는지를 바꾸는 데 더 쓰십시오.
진단과 치료
왜 모니터링만으로는 부족합니까?
모니터는 이 일에 있는 두 질문 중 쉬운 쪽에 답합니다. 여러분이 어디에 서 있는지, 어떤 프롬프트가 여러분을 언급하고 어떤 프롬프트가 인용하는지, 각 답변이 어떤 출처에서 가져왔는지입니다. 진단이 혼자서 결과를 바꾼 적은 없습니다.
실패 유형은 대기열입니다. 알림이 쌓이고 인용된 URL 목록이 길어지는데, 각 스레드를 읽고, 진짜로 보탤 것이 있는지 판단하고, 어울리는 목소리로 초안을 쓰고, 승인을 받을 사람은 이미 한 주가 꽉 찬 바로 그 사람입니다. 스레드는 낡고, 첫째 주에 열려 있던 질문은 셋째 주에 다른 누군가가 답해 버립니다.
목록을 바꾸는 것은 목록이 가리키는 느린 일입니다. 실제로 리트리벌되고 있는 스레드에서, 이력이 있는 계정으로, 독자가 행동에 옮길 수 있는 무언가를 보태는 답글을 쓰고, 필요한 곳에서는 관계를 밝히는 일입니다. 주간 워크플로와 프로그램 실패 유형을 참고하십시오.
측정
스스로를 속이지 않고 인용 비중을 측정하려면 어떻게 해야 합니까?
측정하기 전에 프롬프트 세트를 고정하고, 작업을 바꾸는 기간에는 절대 세트를 바꾸지 마십시오. 보고할 것은 세 가지입니다. 언급 비중은 여러분 브랜드의 이름이 불린 실행의 비율입니다. 인용 비중은 인용된 URL 중 여러분의 것이거나 여러분을 설명하는 것의 비율입니다. 점유율은 이름이 불린 대안들과 비교한 몫입니다. 순위는 보고하지 마십시오. 그 아래에 순위가 매겨진 목록이 없기 때문입니다.
그다음 반복하십시오. 같은 ACL 2026 연구는 생성형 출력이 시간과 실행에 따라 달라진다는 것을 발견했고, 그래서 프롬프트 하나를 한 번 돌린 결과로는 알 수 있는 것이 없습니다.4 기간마다 프롬프트당 여러 번 실행하는 것이 변화와 노이즈를 가르는 최소한입니다. 신뢰할 수 있는 지표, 통계적 검정력, 여섯 가지 가시성을 참고하십시오.
이 글의 정직한 한계
여기서 세 가지는 보이는 것보다 약합니다. 영향력이 높은 페이지의 윤곽은 프롬프트 602건이라는 단일 데이터셋에 기반한 서술적 프리프린트에서 나왔고, 페이지 특징과 인용 사이의 상관관계는 그 특징을 추가하면 인용이 일어난다는 증거가 아닙니다. 업보트, 댓글 깊이, 계정 나이가 AI 인용을 좌우한다는 주장은 이 글이 확인할 수 있었던 어떤 연구도 뒷받침하지 않으므로, 위의 어떤 내용도 그것에 기대지 않습니다. 그리고 인용한 Reddit 백분율은 모두 저마다 분모를 가진 벤더 측정이며, 그중 하나는 벤더 스스로 잠정적이라고 부릅니다.
제품이 쓸모 있는 자리와 그렇지 않은 자리
무료 버전은 오후 한나절이면 됩니다. 상업적으로 가장 중요한 질문 열 개를 신경 쓰는 엔진마다 돌리고, 인용된 URL을 모두 기록하십시오. Bavior는 고정된 프롬프트 세트를 다섯 개 엔진에 일정대로 실행하고 각 답변이 어떤 출처를 인용했는지 기록하므로, 이 목록이 최신 상태로 유지됩니다. 인용된 출처가 진행 중인 토론 스레드이면 여러분의 목소리로 답글 초안을 쓰고, 여러분이 승인하기 전에는 아무것도 게시되지 않습니다. 게시는 Bavior의 오래된 계정으로 하거나 여러분 자신의 계정으로 직접 합니다. Bavior는 엔진이 여러분을 인용하게 만들 수 없고, 게재 자리를 사지 않으며, 여러분이 읽지 않은 것은 아무것도 게시하지 않습니다. 유료 플랜은 월 $99부터입니다.
출처, 모두 2026년 9월 12일 확인
Zhang, He, Yao, “From Citation Selection to Citation Absorption”, 2026년 4월 28일, arXiv:2604.25707(프리프린트); 프롬프트 602건, 인용 21,143건, 가져온 페이지 18,151개: arxiv.org/abs/2604.25707
Ahrefs, “Most cited domains in ChatGPT”, 2026년 9월 2일 업데이트; Brand Radar; 상위 50개 출처의 인용 합계 대비 언급 비중; reddit.com 16.8%, 1위. 벤더 측정이므로 /learn 출처 규칙에 따라 링크하지 않음.
Semrush, “Reddit AI search visibility study”, 2025년 11월 10일; 프롬프트 217,000건, Reddit URL 248,000개; ChatGPT Search 답변의 12.6%에 Reddit 등장. 벤더, 링크 없음.
Profound, Reddit과 공동, 2025년 11월 10일; 인용 40억 건, 2024년 8월부터 2025년 10월까지; 전체 인용의 3.11%가 Reddit, ChatGPT에서 2위. 벤더, 링크 없음.
Promptwatch, Danny Goodwin(Search Engine Land)과 Matt G. Southern(Search Engine Journal) 보도, 2026년 8월 19일; 3.83%에서 0.52%로, 잠정적 결과로 명시. 벤더, 링크 없음.
누구도 날짜를 줄 수 없고, 날짜를 주는 사람은 무언가를 팔고 있습니다. 접근은 OAI-SearchBot 차단을 푸는 즉시 열립니다. 그 뒤로는 엔진이 발행하기로 한 질문에 맞는 문서가 존재하는지, 그리고 버전 사이에 움직이는 인용 세트에 달려 있습니다. 분기 단위로, 그리고 비중으로 측정하십시오.
GPTBot을 차단하면 ChatGPT 검색에 나타나지 않게 됩니까?
아닙니다. OpenAI는 역할을 나눕니다. GPTBot은 모델 학습용이고, 검색 결과를 관할하는 것은 OAI-SearchBot입니다. 문서에는 OAI-SearchBot을 거부한 사이트는 ChatGPT 검색 답변에 표시되지 않으며, ChatGPT-User는 콘텐츠가 검색에 나타날 수 있는지를 결정하는 데 쓰이지 않는다고 적혀 있습니다. 여러분의 robots.txt가 실제로 어느 것을 차단하는지 확인하십시오.
업보트가 많으면 Reddit 스레드가 인용될 가능성이 높아집니까?
이 글이 확인할 수 있었던 연구 중에 업보트 수, 댓글 깊이, 계정 나이를 인용 선택의 입력으로 측정한 것은 없습니다. 근거가 뒷받침하는 것은 오히려 문서의 형태와 쿼리와의 맞물림입니다. 여러 사람이 선택지를 비교한 스레드는 선택지 하나를 다룬 페이지보다 비교형 질문에 더 잘 답합니다. 업보트 주장은 검증되지 않은 속설로 다루십시오.
ChatGPT 인용에서 Reddit의 비중이 떨어졌는데도 공을 들일 가치가 있습니까?
벤더의 백분율이 아니라 적합성으로 판단하십시오. 같은 해 같은 도메인에 대해 발표된 수치가 0.52%에서 16.8%까지 벌어지는 것은 저마다 나누는 대상이 다르기 때문이고, 그중 하나는 잠정치로 표시되어 있습니다. 여러분의 프롬프트를 직접 돌리고, 여러분 카테고리에서 실제로 무엇이 인용되는지 보고, 스레드가 나타나는 곳에 쓰십시오.
Bavior 편집팀
Reddit 마케팅과 AI 검색 가시성에 관한 Bavior의 콘텐츠를 조사하고 관리하는 팀입니다. 본문의 모든 수치에는 출처와 확인 날짜를 명시했으며, 제휴 링크는 사용하지 않습니다.