首頁/學習 GEO/討論串如何入選
站外 GEO · 專題

一則社群討論串是怎麼被選進 AI 答案的?

走的是那條尋常的檢索管線,只有一處不同,而它決定了一切:在論壇上,擋在頁面前面的每一道閘門都屬於別人。

本頁內容
分享本文
簡短回答

一則社群討論串,是被跟其他任何頁面相同的管線選中的:它必須已被收錄且抓得到,必須匹配上引擎生成的某一條子查詢(而不是某個人打下的那句問題),還必須挺過一個引擎之外沒有人能檢視的重排器。真正不同的是歸屬權,不是機制,因為上面每一道閘門都屬於託管這則討論串的平台。在 2025 年 9 月採集的 4,706 條查詢裡,Google AI Overview 查閱過的網域有 53% 不在自然結果前十,27% 不在前一百,所以一則討論串在普通搜尋裡的名次,幾乎說明不了引擎會不會夠得到它。3

關鍵要點
  • 選中就是搜尋:Google 表示其生成式功能「根植於我們核心的搜尋排序與品質系統」,而一個支持連結「必須已被收錄,並且有資格帶著摘要出現在 Google 搜尋裡」。12
  • 匹配的單位是一條生成出來的子查詢,所以一則討論串是為了答案的某一個側面被挑走的,不是為了你的品類。
  • 靠寫作去爭取被選中幾乎行不通:NeurIPS 2025 的一項基準測試在 54 個案例中只有 3 個顯著,KDD 2026 上十種正文策略全部低於基線。67
  • 被引用既不等於被如實表述,也不等於被造訪:51.5% 的生成句子被引用完全支持,而摘要內來源的點擊只發生在 1% 的造訪裡。810
準入

一則討論串能被選中之前,必須先成立哪些事?

四件事,而且沒有一件跟這則討論串寫得好不好有關。它必須待在引擎的索引裡,或者在提問當下抓得到;託管它的平台必須允許那次抓取;這個 URL 必須仍然回傳被抓取時的那些文字;而且裡面必須有某個段落與引擎真正發出的某條查詢相關。Google 把第一條要求寫得很清楚:要有資格成為支持連結,頁面「必須已被收錄,並且有資格帶著摘要出現在 Google 搜尋裡,滿足搜尋的技術要求」(頁面最後更新於 2025 年 12 月 10 日)。1

在你自己的網站上,這裡每一條都是你一個下午就能改的設定,也正是檢索那一篇整篇在講的東西。在一則討論串上,這些都不歸你。你是在往另一個機構經營的資產裡貢獻文字,而那份資產的檢索性質,是那個機構的產品決策。

01

託管方的收錄設定

可收錄性與摘要資格,是在平台自己的標記和標頭裡設定的。一個把舊存檔設成 noindex 的社群,會把好幾年的討論串從每一個讀取它的引擎裡移走。

02

託管方的爬蟲策略

一項 11,500 條查詢的基準測試發現,封鎖 Google AI 爬蟲的網站被 AI Overviews 檢索到的可能性顯著更低,儘管系統本來就能存取那些內容。4 那條策略就是一個檔案,而它不在你的路線圖上。

03

URL 能不能存活

一則被刪的留言、一則被鎖的討論串、一個轉為私密的社群、一個被刪除的帳號,都會讓引用斷掉。在引擎已經引用過的 URL 裡,2026 年的一項測量發現有 27.1% 根本抓不下來。11

匹配的單位

一則討論串實際被拿去匹配的是哪個問題?

不是你的買家打下的那一句。檢索是按每一條生成出來的子查詢各跑一次的。

Google 在自己的介面上把這個機制寫進了文件:AI Overviews 與 AI Mode「可能會使用一種『查詢扇出』技術,在子主題與資料來源之間發出多條相關搜尋,來構建一則回應」。1 一則講怎麼從某個特定工具遷移出來的討論串,爭的是遷移那個子問題;它可以拿下那個片段,同時在任何真人會打出來的問題上都毫無排名。

被測到的後果是:候選集不是一頁搜尋結果。發表於 Findings of ACL 2026、資料採集於 2025 年 9 月的一項 4,706 條查詢審計寫道,「平均而言,AIO 查閱的網域有 53%(27%)不在自然搜尋前 10(前 100)名結果之內」。3 一份規模更大的預印本涵蓋 55,393 條熱門查詢、採集於 2026 年 3 月 13 日至 4 月 21 日,發現 AI Overview 引述的網域有 29.8% 不出現在對應的第一頁上。5 兩者的動詞不同,一個是查閱,一個是引述,所以請把這一對讀成一個區間。

Google 自己那句話,「我們在 Google 搜尋上的生成式 AI 功能,根植於我們核心的搜尋排序與品質系統」(頁面最後更新於 2026 年 7 月 10 日),與此並不衝突。2 排名是候選被抽取出來的那層基底;候選集是按子查詢組裝的,並不是某個人本來會看到的那份清單。對討論串這件事來說:一則討論串是不是排在論壇自己的排序最前面,幾乎無關緊要;它裡面某一個段落是否逐字回答了一個很窄的子問題,才是決定性的。至於為什麼你靠搜尋找得到的討論串是個有偏樣本,請看把討論串當作 prompt 來源的那一篇:社群討論串。

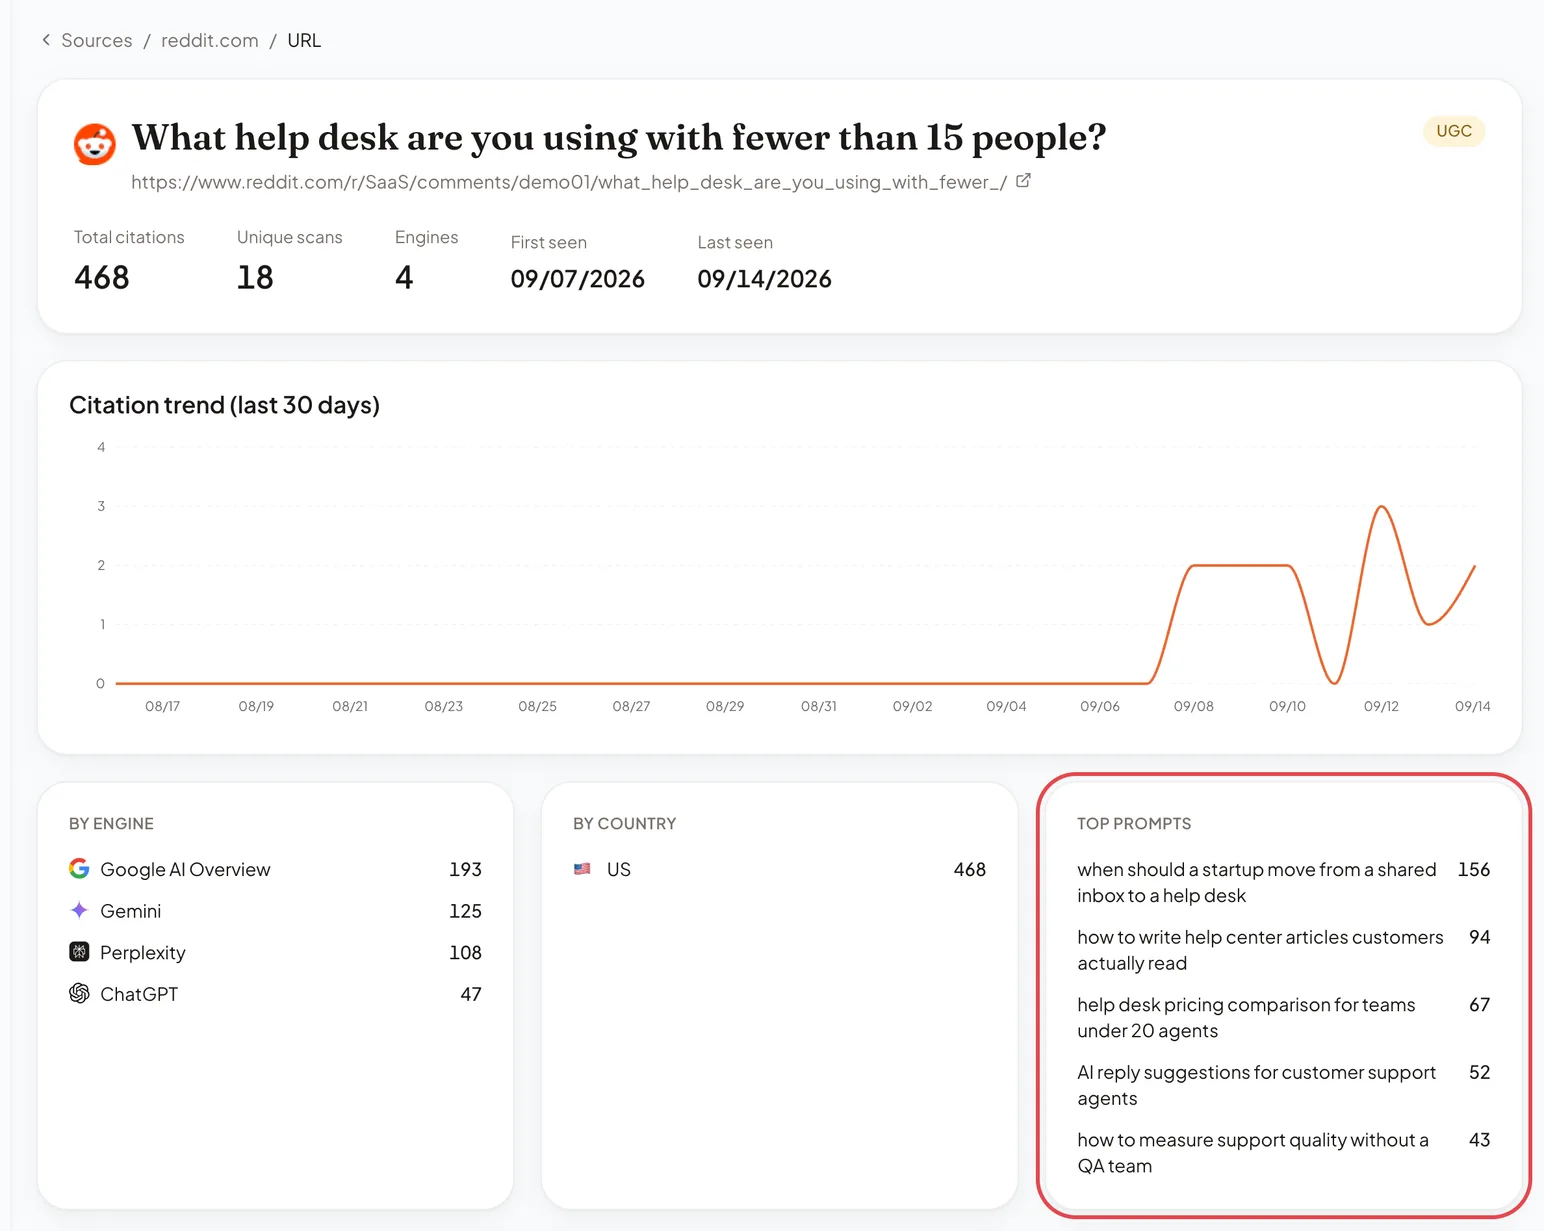
想看清一則討論串是因為你自己的哪些問題被引用的,就在 Bavior 裡從 Sources 打開它。Top prompts 列出讓引擎引用這一則討論串的那些追蹤 prompt,所以請逐個問題去判斷它,而不是看它的標題。

Bavior detail page for one cited Reddit thread: total citations, unique scans, engines, the 30-day citation trend, citations by engine and country, and the top prompts it was cited for
示範工作區中的範例資料。討論串標題僅為示意,並非真實的 Reddit 貼文。紅框標出的是 Top prompts,也就是這一則討論串被引用時對應的那些追蹤 prompt。
寫作的邊界

你能寫出一則讓它被選中的回覆嗎?

幾乎不能。兩項測試內容側優化的基準測試都發現它無效,而其中把檢索也一起跑起來的那一項,發現它有害。

人們會去嘗試的做法測量發現了什麼結論
把段落改寫得讀起來更權威十種內容方法、54 個案例,3 處顯著提升沒有可靠效果
各種正文優化策略十種策略,三項報告均值全部低於基線平均而言是負的
爭取在上下文裡拿到更好的位置引用排名 2.77 位(標準差 2.31),對比 0.36(標準差 1.47)已發表證據裡最強的槓桿,不是寫作技巧

C-SEO Bench 是 NeurIPS 2025 資料集與基準賽道的一篇論文,涵蓋超過 1.9k 條查詢與 16k 份文件,測試了十種方法,結論是「目前多數 C-SEO 方法不僅在很大程度上無效,而且經常對文件排名產生負面影響,這與預期正好相反」。它的 6.2 節說得更直白:「在 54 個案例中,我們只發現三處排名提升具有統計顯著性。」6

被 KDD 2026 接收的 SAGEO Arena,透過一條把檢索與重排都保留在內的管線,走到了同一個地方。十種策略只施加在正文上,得到的均值是 0.53、0.84 和 0.47,對應基線是 0.58、1.00 和 0.50,三項全部下移;論文報告說,現有做法「經常在檢索與重排環節拉低表現」。7

能在這套證據下活下來的東西並不光鮮,但依然值得做。回答這則討論串真正問的那個問題,放在第一句,長度控制在陌生人願意讀完的範圍。揭露商業利益:很多社群在自己的規則裡就要求這樣做,在那裡什麼算數,權威是每個社群自己的規則頁;而沒有揭露的廠商式回答,正是版主會刪掉的那一則。絕對不要買讚、開分身帳號或組織起鬨:那是操弄,它終結的是帳號,不是這波投放。這些都不是什麼被選中的技巧;它們是你被允許把文字留在引擎可能找得到的地方,所要付的代價。

如實表述

討論串被選中了,答案說的就是它說的嗎?

常常並不完全是。生成式搜尋引用品質那份奠基性的審計(發表於 Findings of EMNLP 2023)發現,「平均而言,只有區區 51.5% 的生成句子被引用完全支持,也只有 74.5% 的引用支持它所附的那句話」。8 那份 55,393 條查詢的預印本在主張層級測量了同一種失敗,報告 98,020 條原子主張中有 11.0% 沒有支持。5

規模最大的獨立檢驗來自 Tow Center:它把一千六百條查詢投給八個引擎,發現它們「超過 60% 的查詢」答錯了。最差的那個引擎答錯了 94% 的查詢,而在為它測試的 200 條 prompt 裡,有 154 條引用指向錯誤頁(核查於 2026 年 8 月 30 日)。9 請把這個分母搞清楚:200 數的是 prompt,不是引用。

對站外工作來說,結論很具體:你的回覆成為被引用的來源,並不代表讀者看到的就是你那句話;一條指向該討論串的連結,也不是它被正確讀懂了的證據。先讀答案正文,再讀引用清單,並把兩者不一致當成常態。引用準確度那一篇講這道缺口被測到了什麼程度。

後果

成為那則被引用的討論串,能給你帶來人嗎?

很少,按目前公開唯一一份大規模行為測量看是這樣。皮尤研究中心追蹤了 900 名美國成年人在 2025 年 3 月的瀏覽行為,涵蓋 68,879 條不重複的 Google 搜尋,發現在帶 AI 摘要的頁面上,摘要內連結被點擊「只發生在全部造訪的 1%」(核查於 2026 年 8 月 30 日)。10 那是一個國家、一個引擎、一個月份,而它依然是這個領域裡最乾淨的數字。

2026 年那篇批判性綜述把「引用分數能預測點擊、轉換或營收」這個主張評為極低信心。11 一則被引用的討論串值得擁有,理由是另一個:它是你的買家從未造訪你時,引擎講給他聽的那段話。請把它當作答案裡的佔比來衡量,而不是當作一條流量通路,這也正是站得住的指標那一篇的主張。

可重複性

單一討論串的「被選中」有多可重複?

不太可重複,而且不穩定發生在單一來源那一層,不是整體畫面那一層。那項 11,500 條查詢的 SIGIR 2026 基準測試觀察到,AI Overviews「在同一條查詢跑兩遍時一致性更差,對細微的查詢改動也更不穩健」。4 2026 年那篇批判性綜述報告,溫度為零時重複執行會改變 9% 到 28% 的判定;另一項涵蓋四個引擎、把同一批查詢連跑 45 天的研究,在一個規模不大的瑞士查詢集合上,測得相鄰兩天之間來源層級的 Jaccard 為 0.34 到 0.42。11

因此,對一則答案的一次觀測,不構成關於一則討論串的證據。本站報告比例時用的是 95% Wilson 區間,它在 p 為 0.5 時的半寬是 1.96 除以二倍根號(n 加 3.84):五次執行大約是正負 33 個百分點,三十次是正負 17,兩百次是正負 7。任何「這則討論串現在更常被選中」的說法,都必須挺過這個區間,這表示要按排程記錄被引用的 URL,而不是靠手動查兩次。統計檢定力那一篇把這套算術從頭走了一遍。

本文的誠實邊界

沒有任何一手研究把社群討論串當作一個來源類別來測量。上面每一條機制性主張,測的都是廣義的開放網路,再靠論證套用到討論串上,不是靠直接觀測。那些通常被拿來講被引用討論串的數字,也就是它們的存在時間、長度和讚數,都是廠商發布的,方法不揭露;社群討論串那一篇處理它們,而本文刻意一個都不採用。本文出處中有三條是預印本;註 8 那份審計測的四個引擎此後已被下線或重建。本文沒有任何內容能確立你寫下的某則回覆會被選中。

產品在哪裡派得上用場,在哪裡派不上

Bavior 無法讓引擎去選中一則討論串,無法讓被刪的貼文恢復,無法改變某個社群的爬蟲或收錄策略,也不知道一則討論串的作者到底是不是你的買家。它做的是另一件事:把後果記錄得夠多次,多到它開始有意義。一組固定的 prompt 按排程跨五個引擎執行,每一個被引用的 URL 都記錄下來,於是你看得到什麼時候替你的買家作答的是一則討論串而不是你自己的頁面,以及有多頻繁。當被引用的來源是一則活著的討論串時,Bavior 會在你掌控的帳號上、按那個社群自己的規則起草一則回覆,任何內容送出之前都由你審核;它不碰投票。免費 AI 能見度檢測和免費 GEO 健檢不需要付費方案;付費方案按月計費 $99/月起,按年計費折合 $79.17/月(截至 2026 年 8 月 30 日)。

出處,全部為一手來源,均於 2026 年 8 月 30 日重新核查
  1. Google Search Central,《AI features and your website》,最後更新於 2025 年 12 月 10 日(摘要資格;查詢扇出;第一方):developers.google.com/search/docs/appearance/ai-features
  2. Google Search Central,《Google’s Guide to Optimizing for Generative AI Features on Google Search》,最後更新於 2026 年 7 月 10 日(「根植於」那句話;第一方):developers.google.com/search/docs/fundamentals/ai-optimization-guide
  3. Kirsten 等,《Characterizing Web Search in The Age of Generative AI》,Findings of ACL 2026;4,706 條查詢,2025 年 9 月;“53% (27%) of domains that AIO consults are not contained in top-10 (top-100) Organic search results”:aclanthology.org/2026.findings-acl.526
  4. Grossman 等,《How Generative AI Disrupts Search》,SIGIR 2026,arXiv:2604.27790;11,500 條查詢;封鎖 AI 爬蟲會降低 AIO 的檢索;AIO 在同一條查詢的兩次執行之間不一致:arxiv.org/abs/2604.27790
  5. Xu、Iqbal 與 Montgomery,《Measuring Google AI Overviews》,2026 年預印本;55,393 條熱門查詢,2026 年 3 月 13 日至 4 月 21 日;引述的網域有 29.8% 不出現在第一頁;98,020 條原子主張中有 11.0% 無支持:arxiv.org/abs/2605.14021
  6. Puerto 等,《C-SEO Bench: Does Conversational SEO Work?》,NeurIPS 2025 資料集與基準賽道,arXiv:2506.11097;十種方法;§6.2「在 54 個案例中,我們只發現三處排名提升具有統計顯著性」;表 3 零售 2.77 ±2.31 對比 0.36 ±1.47:arxiv.org/abs/2506.11097
  7. 《SAGEO Arena》,arXiv:2602.12187v2,KDD 2026;表 2「Body Text only」均值 0.53、0.84、0.47,對應基線 0.58、1.00、0.50,十種策略:arxiv.org/abs/2602.12187
  8. Liu、Zhang 與 Liang,《Evaluating Verifiability in Generative Search Engines》,Findings of EMNLP 2023,arXiv:2304.09848;“a mere 51.5% of generated sentences are fully supported by citations and only 74.5% of citations support their associated sentence”:arxiv.org/abs/2304.09848
  9. Jaźwińska 與 Chandrasekar,《AI Search Has a Citation Problem》,Tow Center for Digital Journalism;一千六百條查詢、八個引擎;超過 60% 的查詢答錯;最差引擎 94%,200 條 prompt 中有 154 條引用指向錯誤頁:cjr.org/tow_center
  10. 皮尤研究中心,《Google users are less likely to click on links when an AI summary appears in the results》,2025 年 7 月 22 日;900 名美國成年人、68,879 條搜尋,2025 年 3 月;“in just 1% of all visits”:pewresearch.org/short-reads/2025/07/22
  11. 《Optimizing Visibility in Generative Engines: A Critical Survey》,2026 年 7 月 15 日,arXiv:2607.14035(預印本);報告 27.1% 被引用的 URL 抓不下來(Allaham 與 Diakopoulos)、溫度為零時 9% 到 28% 的判定發生改變(Kirsten 等)、45 天內每日 Jaccard 為 0.34 到 0.42(Schulte 等),以及把引用分數預測點擊或營收評為極低:arxiv.org/abs/2607.14035
常見問題

你想知道的,都在這裡。

引擎要引用一則討論串,它必須先在 Google 有排名嗎?

不必,而且它的排名的預測力比多數人以為的要弱。發表於 Findings of ACL 2026 的一項 4,706 條查詢審計發現,AI Overview 查閱的網域中,平均有 53% 不在該查詢的自然結果前十,27% 不在前一百。原因是查詢扇出:檢索是按每一條生成出來的子查詢跑的,所以一則討論串可以在某個問題片段上是很強的候選,卻在那個問題本身上毫無排名。

我能寫出一則讓引擎來引用我的回覆嗎?

已發表的證據說,不存在可靠的做法。C-SEO Bench 這項 NeurIPS 2025 的基準測試涵蓋十種內容方法,在 54 個案例中只找到三處統計顯著的排名提升,並且報告說多數方法反而經常損害排名。KDD 2026 的 SAGEO Arena 把十種策略施加在正文上,三項報告均值全部低於基線。請把問題回答好,按社群自己的規則揭露你的利益關係,並把被選中當成一件你去觀察的事,而不是一件你能買到的事。

如果被引用的來源就是我那則回覆,答案說的就是我的觀點嗎?

並不可靠。Findings of EMNLP 2023 那份對生成式搜尋的審計發現,只有 51.5% 的生成句子被引用完全支持,也只有 74.5% 的引用支持它所附的那句話。2026 年一篇預印本測得,AI Overview 裡 98,020 條原子主張中有 11.0% 沒有支持。請去讀答案正文,而不是引用清單,並且要預期兩者經常對不上,對不上才是常態。

一則討論串的引用變化要跑多少次才算真的?

比抽查要多。已有測量顯示,溫度為零時重複執行會改變 9% 到 28% 的判定;另一項涵蓋四個引擎、把同一批查詢連跑 45 天的研究測得,相鄰兩天之間來源層級的重疊為 0.34 到 0.42。用 95% Wilson 區間算,五次執行大約是正負 33 個百分點,三十次是正負 17,兩百次是正負 7。請按排程記錄被引用的 URL,並為每一條記下產品、模式、日期、地區與帳號。

Bavior 編輯部