这个文件是放在站点根目录的一份 markdown 文档,用来给语言模型一张简短的、精选过的地图,标出值得读的页面。Jeremy Howard 于 2024 年 9 月 3 日发布了这份提案,最近一次修改是 2026 年 8 月 10 日。1 格式很小:“一个写明项目或站点名称的 H1,这是唯一的必填部分”,然后是一段引用块摘要,以及若干装着链接列表的 H2 小节。
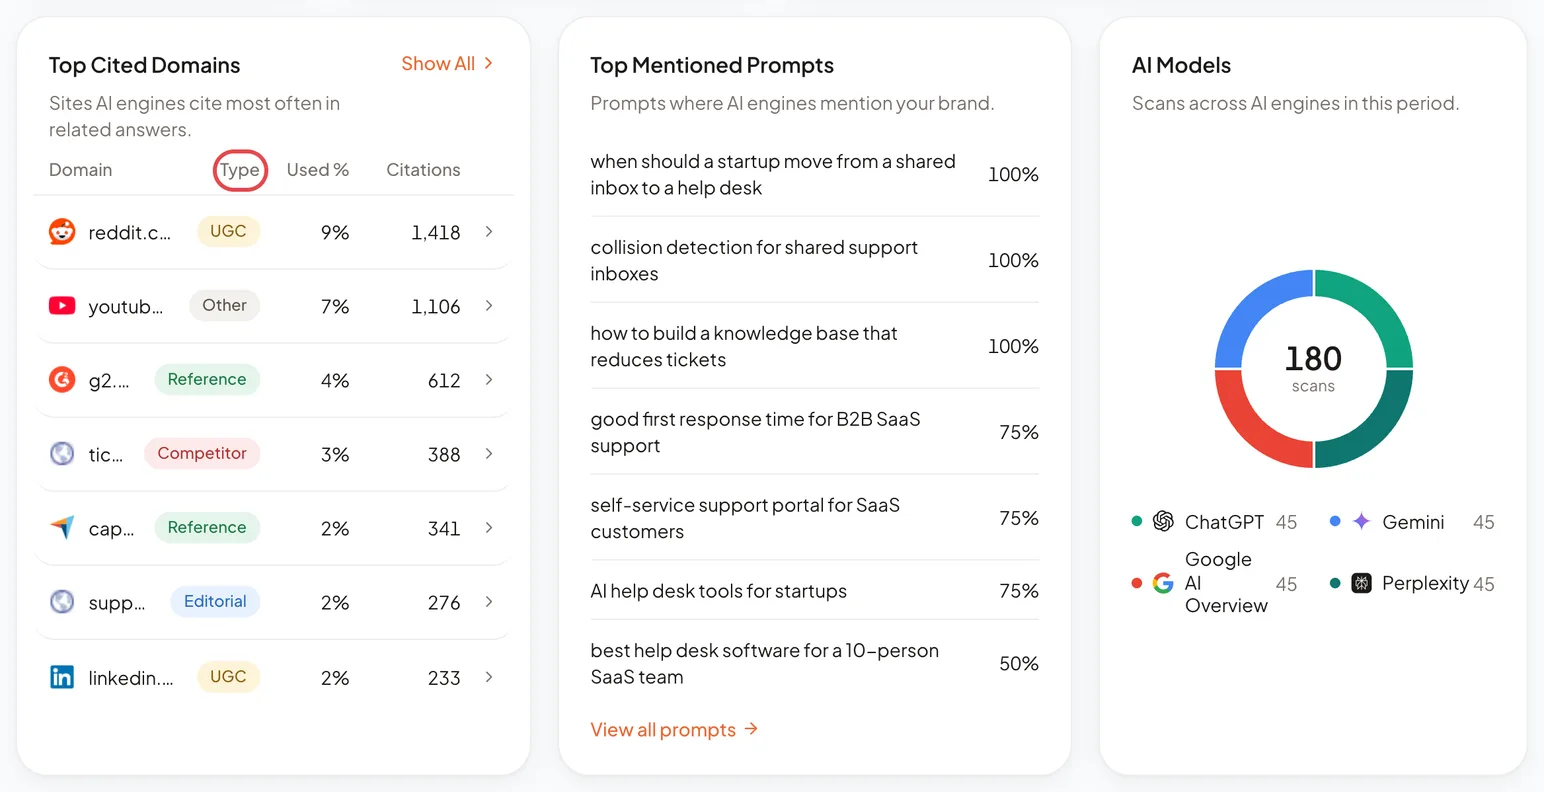
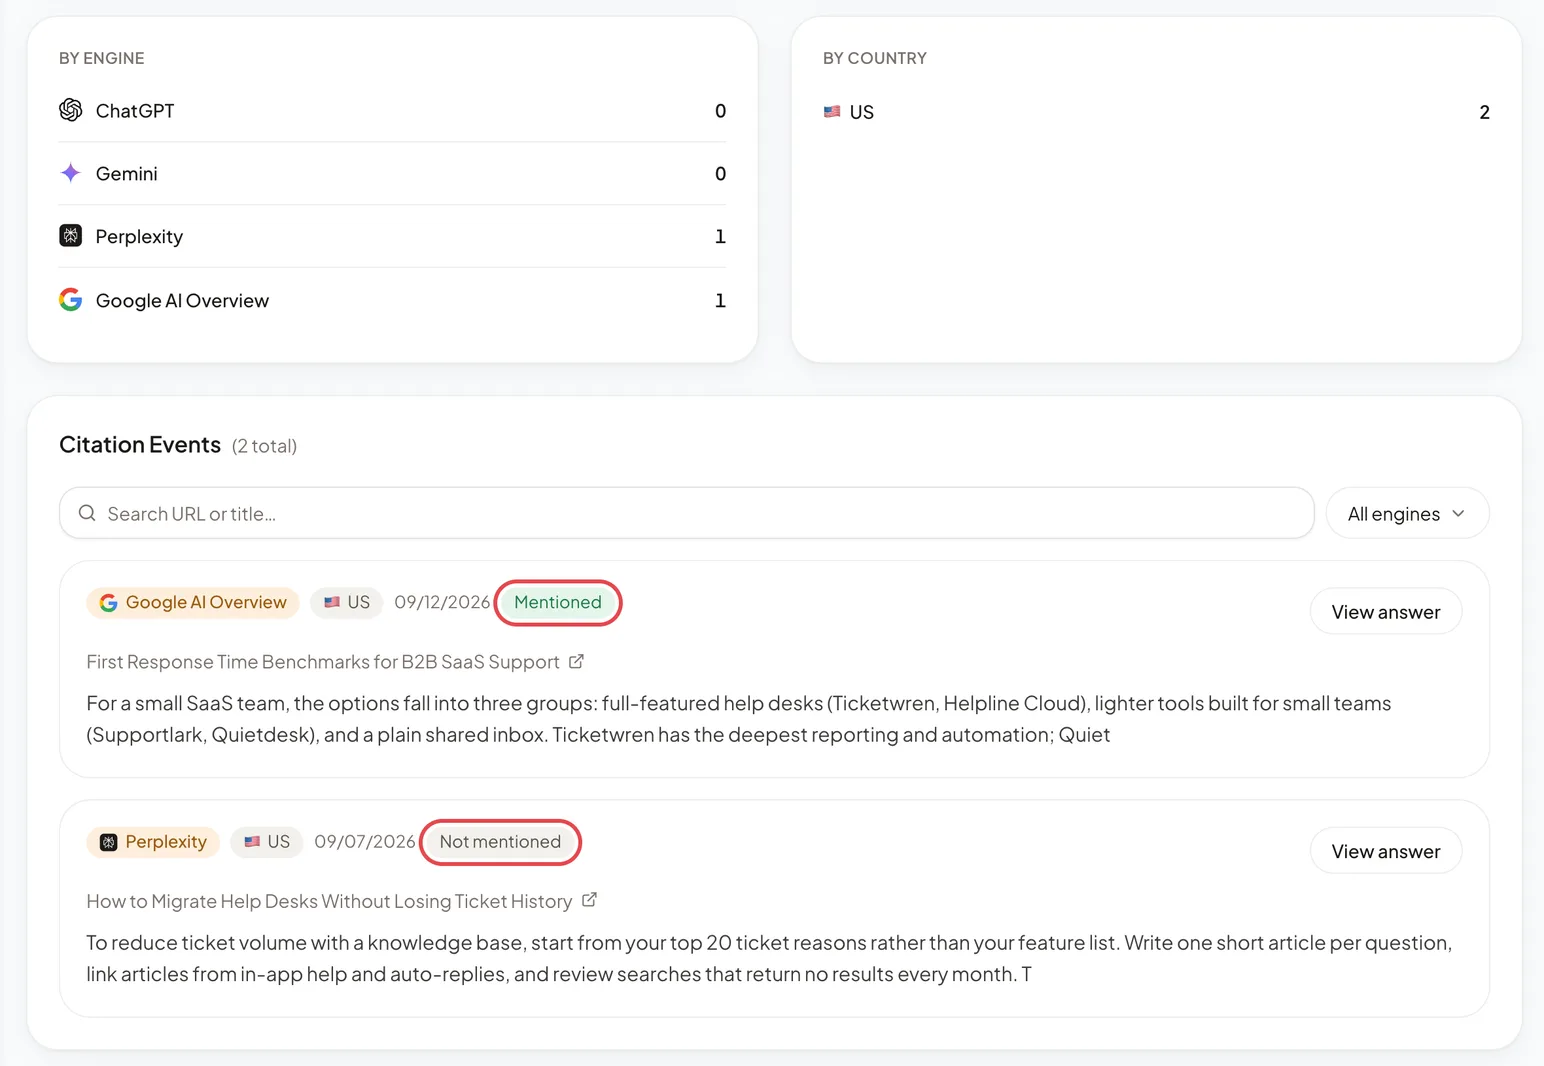
先看适用范围。作者预期这个文件“主要用于推理而非训练”:也就是一个代理在替用户干活时去抓取文档。1 在 ChatGPT 的回答里被提到,并不是提案描述过的用途。
采用率和读取率指向相反的方向。在 2026 年 6 月那项日志研究里,137,210 个域名中有 28% 发布了这个文件,但其中 97% 的有效文件在 2026 年 5 月一次请求都没有;在确实到来的请求里,AI 检索机器人只占 1.1%,SEO 体检工具则占 21.7%。3 更早一项发布于 2025 年 11 月 7 日、覆盖近 30 万个域名的研究发现采用率为 10.13%,并且“有没有这个文件”与“有没有被引用”之间没有关系。4
厂商的说法一致。Google 的生成式 AI 功能指南(最后更新于 2026 年 7 月 10 日)直接点了这个文件的名:创建它“对你的网站在 Google 搜索中的可见性或排名既无害也无益,因为 Google 搜索会忽略它们”。2 John Mueller 在 r/TechSEO 上说得更直白,据 2026 年 7 月 6 日的报道:“我不知道有任何其他爬虫或 LLM 确认在使用它们”。5 OpenAI 和 Anthropic 在文档里都把 robots.txt 当作控制手段,两家都没有写过自家爬虫会读取这个文件。67
我们的证据综述 《篇幅、schema 与 llms.txt》 涵盖了迄今做过的每一项研究。这些记录证明了什么:格式是真实存在的,也很容易满足。它没解决什么:读者在哪里。