首页/学习 GEO/帖子如何被选中
站外 GEO · 专题

一个社区帖子是怎样被选进 AI 答案的?

走的是那条寻常的检索流水线,只有一处不同,而它决定了一切:在论坛上,挡在页面前面的每一道闸门都属于别人。

本页内容
分享本文
简短回答

一个社区帖子,是被与其他任何页面相同的流水线选中的:它必须已被收录且抓得到,必须匹配上引擎生成的某条子查询(而不是某个人打下的那句问题),还必须挺过一个引擎之外无人能查看的重排器。真正不同的是归属权而不是机制,因为上面每一道闸门都属于托管这个帖子的平台。在 2025 年 9 月采集的 4,706 条查询中,Google AI Overview 查阅过的域名有 53% 不在自然结果前十,27% 不在前一百,所以一个帖子在普通搜索里的名次,几乎说明不了引擎会不会够到它。3

关键要点
  • 选中就是搜索:Google 表示其生成式功能“根植于我们核心的搜索排序与质量系统”,而一个支持链接“必须已被收录,并且有资格带摘要出现在 Google 搜索里”。12
  • 匹配的单位是一条生成出来的子查询,所以一个帖子是因为答案的某一个侧面被选走的,不是因为你的品类。
  • 靠写作去争取被选中几乎不成立:NeurIPS 2025 的一项基准测试在 54 个案例中只有 3 个显著,KDD 2026 上十种正文策略全部低于基线。67
  • 被引用既不等于被如实表述,也不等于被访问:51.5% 的生成句子被引用完全支持,而只有 1% 的访问产生了对 AI 摘要内来源的点击。810
准入

一个帖子能被选中之前,必须先成立哪些事?

四件事,而且没有一件与这个帖子写得好不好有关。它必须待在引擎的索引里,或者在提问当下抓得到;托管它的平台必须允许那次抓取;这个 URL 必须仍然返回被抓取时的那些文字;而且里面必须有某个段落与引擎真正发出的某条查询相关。Google 把第一条要求写得清清楚楚:要有资格成为支持链接,页面“必须已被收录,并且有资格带摘要出现在 Google 搜索里,满足搜索的技术要求”(页面最后更新于 2025 年 12 月 10 日)。1

在你自己的站点上,这里每一条都是你一个下午就能改的配置,那正是检索阶段整篇讲的东西。在一个帖子上,这些都不归你。你是在往另一个机构运营的资产里贡献文字,而那份资产的检索属性,是它的产品决策。

01

托管方的收录设置

可收录性与摘要资格,是在平台自己的标记和响应头里设定的。一个把旧存档设成 noindex 的社区,会把好几年的帖子从每一个读取该索引的引擎里移走。

02

托管方的爬虫策略

一项 11,500 条查询的基准测试发现,屏蔽了 Google AI 爬虫的站点被 AI Overviews 检索到的可能性显著更低,尽管系统本可以访问那些内容。4 那条策略就是一个文件,而它不在你的路线图上。

03

URL 能不能活下来

一条被删的评论、一个被锁的帖子、一个转为私密的社区、一个被注销的账号,都会让引用断掉。在引擎已经引用过的 URL 里,2026 年的一项测量发现有 27.1% 根本抓不下来。11

匹配的单位

一个帖子实际被拿去匹配的是哪个问题?

不是你买家打下的那一句。检索是按每一条生成出来的子查询各跑一次的。

Google 在自己的界面上把这个机制写进了文档:AI Overviews 与 AI Mode “可能会使用一种‘查询扇出’技术,在子主题与数据源之间发出多条相关搜索,来构建一条回答”。1 因此,一个讲“怎么从某个具体工具迁移出来”的帖子,争的是迁移这个子问题;它完全可能拿下那个片段,同时在任何真人会打出来的问题上都毫无排名。

被测量到的后果是:候选集不是一页搜索结果。发表于 Findings of ACL 2026、数据采集于 2025 年 9 月的一项 4,706 条查询审计写道,“平均而言,AIO 所参考的域名有 53%(27%)不在自然搜索前 10(前 100)名结果之内”。3 另一份更大规模的预印本覆盖 55,393 条热门查询、采集于 2026 年 3 月 13 日至 4 月 21 日,发现 AI Overview 引述的域名有 29.8% 不出现在对应的首页上。5 两者用的动词不同,一个是“参考”,一个是“引述”,所以请把这一对读成区间。

Google 自己那句话,“我们在 Google 搜索上的生成式 AI 功能,根植于我们核心的搜索排序与质量系统”(页面最后更新于 2026 年 7 月 10 日),与此并不矛盾。2 排名是候选被抽取出来的那层基底;而候选集是按子查询组装的,并不是某个人本来会看到的那份清单。对帖子这件事来说,这个结论指向一个有用的方向:一个帖子是不是排在论坛自己排序的最前面,几乎无关紧要;而它里面某一个段落是否逐字回答了一个很窄的子问题,才是决定性的。至于为什么你靠搜索找出来的帖子是个有偏样本,请看把帖子当作 prompt 来源的那一篇。

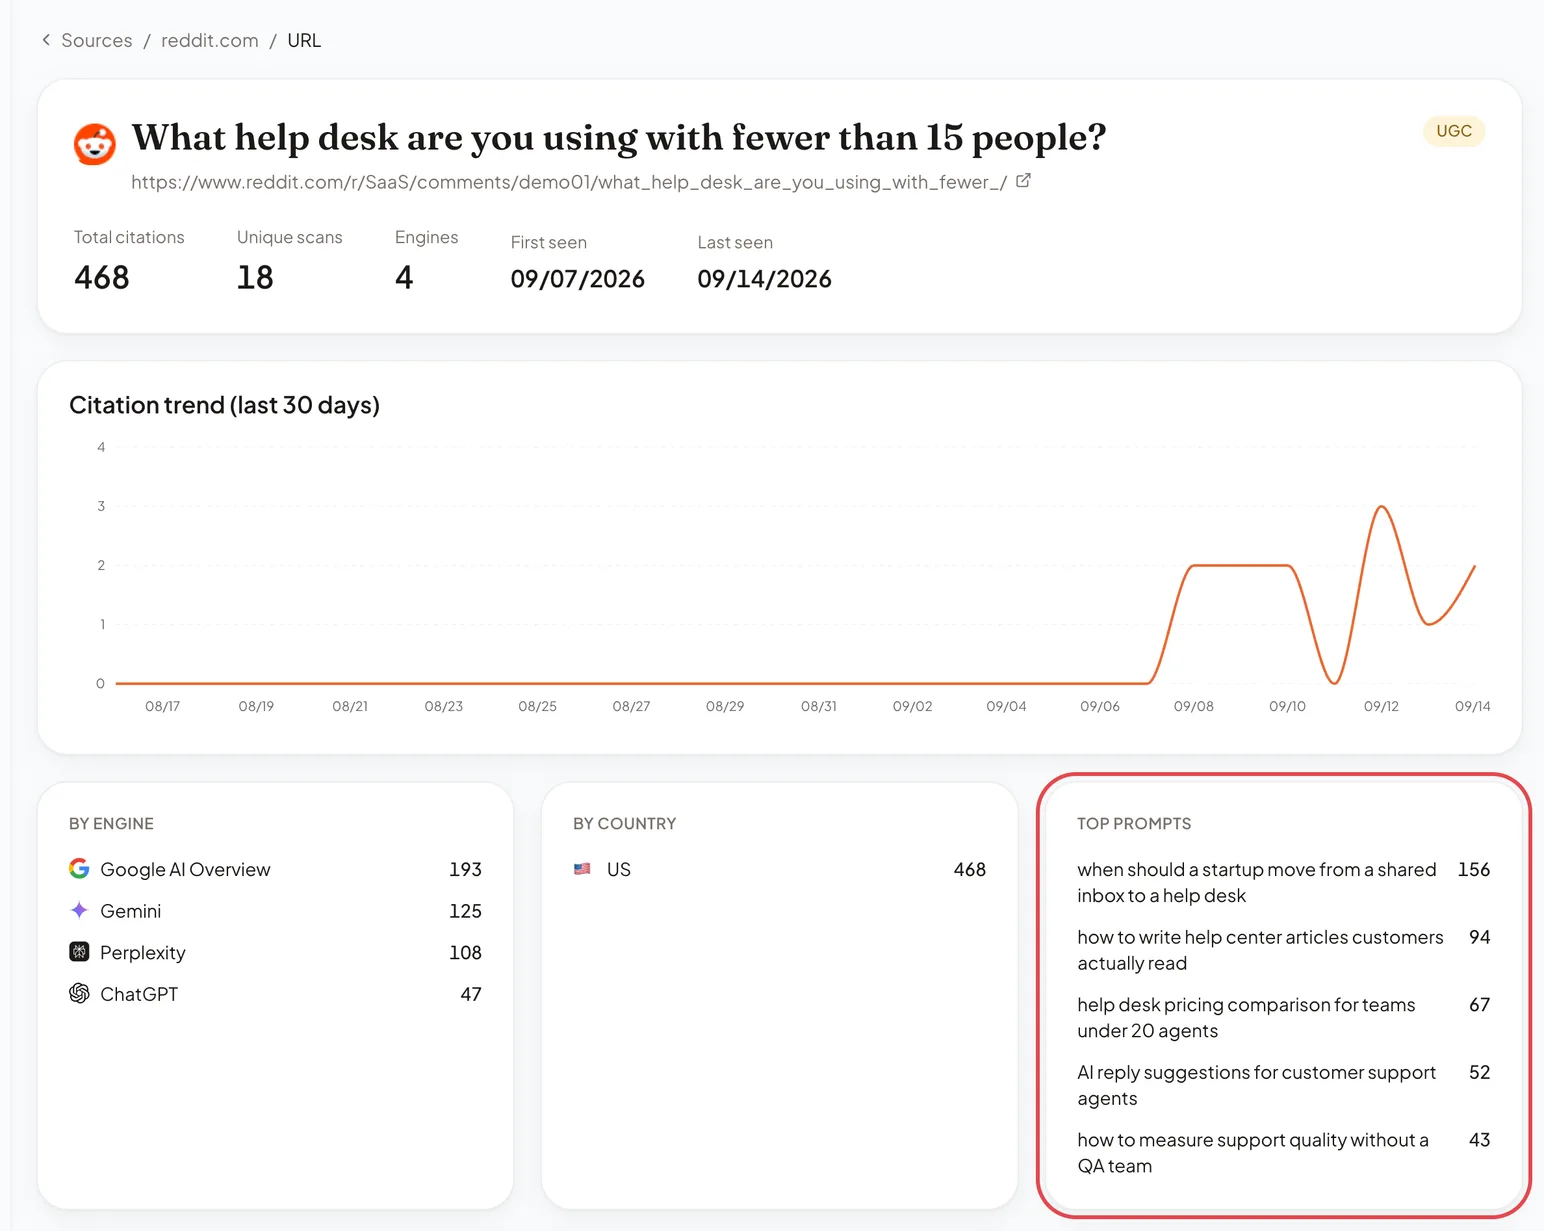
想看清一条帖子是因为你自己的哪些问题被引用的,就在 Bavior 里从 Sources 打开它。Top prompts 列出让引擎引用这一条帖子的那些追踪 prompt,所以请逐个问题去判断它,而不是看它的标题。

Bavior detail page for one cited Reddit thread: total citations, unique scans, engines, the 30-day citation trend, citations by engine and country, and the top prompts it was cited for
演示工作区中的示例数据。帖子标题仅为示意,并非真实的 Reddit 帖子。红框标出的是 Top prompts,也就是这一条帖子被引用时对应的那些追踪 prompt。
写作的边界

你能写出一条让它被选中的回复吗?

几乎不能。两项测试内容侧优化的基准都发现它无效,而其中把检索也一起跑起来的那一项,发现它有害。

人们会去尝试的做法测量结果是什么结论
把段落改写得更像权威口吻十种内容方法、54 个案例,3 处显著提升没有可靠效果
各种正文优化策略十种策略,三项报告均值全部低于基线平均而言是负的
争取在上下文里获得更好的位置引用排名 2.77 位(标准差 2.31),对比 0.36(标准差 1.47)已发表证据里最强的杠杆,不是写作技巧

C-SEO Bench 是 NeurIPS 2025 数据集与基准赛道的一篇论文,覆盖逾 1.9k 条查询、16k 份文档,一共测试了十种方法,其结论是“当前多数 C-SEO 方法不仅在很大程度上无效,而且经常对文档排名产生负面影响,这与预期正好相反”。它的 6.2 节说得更直白:“在 54 个案例中,我们只发现三处排名提升具有统计显著性。”6

被 KDD 2026 接收的 SAGEO Arena,从另一条路走到了同一个地方:它跑的是一条把检索与重排都保留在内的完整流水线。把十种策略只施加在正文上,得到的均值是 0.53、0.84 和 0.47,而基线是 0.58、1.00 和 0.50,也就是三项测度全部下移;论文还报告说,现有方法“经常在检索与重排环节拉低表现”。7

能在这套证据下活下来的东西并不光鲜,但依然值得做。回答这个帖子真正问的那个问题,放在第一句,长度控制在陌生人愿意读完的范围。如实披露商业利益,因为很多社区在自己的规则里就要求这样做,每个社区自己的规则页才是“在那里算不算”的权威,而没有披露的厂商式回答,正是会被版主删掉的那一条。绝不要买赞、开小号或组织起哄:那是操纵,它终结的是账号而不是这次投放。这些都不是什么“被选中的技巧”;它们是你被允许把文字留在引擎可能找到的地方所要付的代价。

如实表述

帖子被选中了,答案说的就是它说的吗?

常常并不完全是。关于生成式搜索引用质量最早那份基础性审计(发表于 Findings of EMNLP 2023)发现,“平均而言,只有区区 51.5% 的生成句子被引用完全支持,也只有 74.5% 的引用支持它所附的那句话”。8 那份 55,393 条查询的预印本测量了同一类失败,报告 98,020 条原子主张中有 11.0% 没有支持。5

规模最大的独立检验来自 Tow Center:它把一千六百条查询投给八个引擎,发现它们“超过 60% 的查询”答错了。最差的那个引擎答错了 94% 的查询,而在为它测试的 200 条 prompt 中,有 154 条引用指向了错误页(核查于 2026 年 8 月 30 日)。9 请把这个分母搞清楚:200 数的是 prompt,不是引用。

对站外工作来说,结论很具体:你的回复成为被引用的来源,并不意味着读者看到的就是你那句话;而一条指向该帖子的链接,也不是“它被正确读懂了”的证据。请先读答案正文,再读引用清单,并把两者不一致当成常态。引用准确性那一篇讲这道缺口被测到了什么程度。

后果

成为那个被引用的帖子,能给你带来人吗?

很少,按目前公开的唯一一份大规模行为测量看是这样。皮尤研究中心追踪了 900 名美国成年人在 2025 年 3 月的真实浏览行为,覆盖 68,879 条不重复的 Google 搜索,发现在带 AI 摘要的页面访问里,用户点击摘要内部链接的情况“只发生在全部访问的 1%”(核查于 2026 年 8 月 30 日)。10 这是一个国家、一个引擎、一个月份的测量,而它依然是这个领域里最干净的数字。

2026 年那篇批判性综述对“从引用跳到收入”这一步说得更直白:它把“引用得分能预测点击、转化或收入”评为极低置信度。11 一个被引用的帖子值得拥有,理由是另一个:它是买家从未访问你时,引擎向他讲述的那段话。请把它当作答案中的占比来衡量,而不是当作一条流量渠道,这也正是指标那一篇的主张。

可重复性

单个帖子的“被选中”有多可重复?

不太可重复,而且不稳定发生在单个来源这一层,不是整体画面那一层。那项 11,500 条查询的 SIGIR 2026 基准测试观察到,AI Overviews “在同一条查询跑两遍时一致性更差,对细微的查询改动也更不稳健”。4 2026 年那篇批判性综述转述的工作发现,在温度为零时重复运行会改变 9% 到 28% 的决策;另一项覆盖四个引擎、把同一批查询连跑 45 天的研究测得,相邻两天之间来源层面的 Jaccard 相似度为 0.34 到 0.42,其查询集是一个规模不大的瑞士语料。11

因此,对一条答案的一次观测,不构成关于某个帖子的证据。本站汇报比例时用的是 95% Wilson 区间,它在 p 为 0.5 时的半宽是 1.96 除以二倍根号(n 加 3.84):五次运行大约是正负 33 个百分点,三十次是正负 17,两百次是正负 7。任何“这个帖子现在更常被选中”的说法,都必须挺过这个区间,这意味着按计划记录被引用的 URL,而不是靠手动查两次。统计功效那一篇把这套算术从头走了一遍。

本文的诚实边界

没有任何一手研究是把社区帖子当作一个来源类别来测量的。上面每一条机制性主张,测的都是广义的开放网络,再靠论证套用到帖子上,而不是对论坛的直接观测。那些通常被引用的、关于被引用帖子的描述性数字,它们的帖龄、长度和赞数,都是厂商发布的,方法不披露,也没有独立复现;配套的那一篇处理它们,而本文刻意一个都不采用。本文出处中有三条是预印本;出处 8 那份引用质量审计测的四个引擎此后已被下线或重建。本文没有任何内容能证明你写下的某条回复会被选中。

产品在哪里派得上用场,在哪里派不上

Bavior 无法让引擎去选中某个帖子,无法把被删的内容恢复,无法改变某个社区的爬虫或收录策略,也不知道发起某个帖子的人到底是不是你的买家。它做的是把后果记录得足够多次,多到它开始有意义:一份固定的 prompt 集按计划跨五个引擎运行,记录每一个被引用的 URL,让你看清什么时候替你回答买家的是一个帖子而不是你自己的页面,以及这种情况有多频繁。当被引用的来源是一条活跃讨论帖时,Bavior 会在你掌控的账号上、按那个社区自己的规则起草一条回复,在任何内容发出之前由你批准;它不碰投票。免费 AI 可见性检测和免费 GEO 体检不需要付费方案;付费方案为按月支付每月 99 美元起,或按年支付每月 79.17 美元(截至 2026 年 8 月 30 日)。

出处,全部为一手来源,均于 2026 年 8 月 30 日重新核查
  1. Google Search Central,《AI features and your website》,最后更新于 2025 年 12 月 10 日(摘要资格要求;查询扇出;第一方文档):developers.google.com/search/docs/appearance/ai-features
  2. Google Search Central,《Google’s Guide to Optimizing for Generative AI Features on Google Search》,最后更新于 2026 年 7 月 10 日(“根植于我们核心的搜索排序与质量系统”;第一方文档):developers.google.com/search/docs/fundamentals/ai-optimization-guide
  3. Kirsten 等,《Characterizing Web Search in The Age of Generative AI》,Findings of ACL 2026;4,706 条查询,2025 年 9 月;原文为“on average 53% (27%) of domains that AIO consults are not contained in top-10 (top-100) Organic search results”:aclanthology.org/2026.findings-acl.526
  4. Grossman 等,《How Generative AI Disrupts Search》,SIGIR 2026,arXiv:2604.27790;11,500 条查询;屏蔽 Google AI 爬虫的站点被 AI Overviews 检索到的可能性显著更低;AI Overviews 在同一查询跑两遍时一致性更差:arxiv.org/abs/2604.27790
  5. Xu、Iqbal 与 Montgomery,《Measuring Google AI Overviews》,2026;55,393 条热门查询,2026 年 3 月 13 日至 4 月 21 日;引述域名有 29.8% 不出现在首页;98,020 条原子主张中 11.0% 无支持(预印本):arxiv.org/abs/2605.14021
  6. Puerto 等,《C-SEO Bench: Does Conversational SEO Work?》,NeurIPS 2025 数据集与基准赛道,arXiv:2506.11097;十种方法;6.2 节“在 54 个案例中,我们只发现三处排名提升具有统计显著性”;表 3 零售领域 2.77 ±2.31 对比 0.36 ±1.47:arxiv.org/abs/2506.11097
  7. 《SAGEO Arena》,arXiv:2602.12187v2,KDD 2026;表 2 “Body Text only” 均值为 0.53、0.84、0.47,对应基线 0.58、1.00、0.50,共十种策略:arxiv.org/abs/2602.12187
  8. Liu、Zhang 与 Liang,《Evaluating Verifiability in Generative Search Engines》,Findings of EMNLP 2023,arXiv:2304.09848;原文为“a mere 51.5% of generated sentences are fully supported by citations and only 74.5% of citations support their associated sentence”:arxiv.org/abs/2304.09848
  9. Jaźwińska 与 Chandrasekar,《AI Search Has a Citation Problem》,Tow Center for Digital Journalism;一千六百条查询、八个引擎;超过 60% 的查询答错;最差引擎 94%,200 条 prompt 中有 154 条引用指向错误页:cjr.org/tow_center
  10. 皮尤研究中心,《Google users are less likely to click on links when an AI summary appears in the results》,2025 年 7 月 22 日;900 名美国成年人、68,879 条搜索,数据为 2025 年 3 月;摘要内链接被点击“只发生在全部访问的 1%”:pewresearch.org/short-reads/2025/07/22
  11. 《Optimizing Visibility in Generative Engines: A Critical Survey》,2026 年 7 月 15 日,arXiv:2607.14035(预印本);其中转述了 Allaham 与 Diakopoulos 关于 27.1% 被引用 URL 抓不下来的结果、Kirsten 等关于温度为零时 9% 到 28% 决策发生变化的结果、Schulte 等关于连续 45 天每日来源级 Jaccard 为 0.34 到 0.42 的结果、把“引用得分能预测点击或收入”评为极低置信度,以及那份可复现字段清单:arxiv.org/abs/2607.14035
常见问题

你想知道的,都在这里。

一个帖子必须先在 Google 有排名,引擎才会引用它吗?

不需要,而且它的排名的预测力比多数人以为的要弱。发表于 Findings of ACL 2026 的一项 4,706 条查询审计发现,AI Overview 查阅过的域名中,平均有 53% 不在该查询的自然结果前十,27% 连前一百都没有。原因是查询扇出:检索是按生成出来的子查询跑的,所以一个帖子完全可以在某个问题片段上是很强的候选,却在那个问题本身上毫无排名。

我能写出一条让引擎来引用我的回复吗?

已发表的证据说,不存在可靠的做法。C-SEO Bench 这项 NeurIPS 2025 的基准测试评估了十种内容侧方法,在 54 个案例中只发现三处统计显著的排名提升,并且报告说多数方法反而经常损害排名。KDD 2026 的 SAGEO Arena 把十种策略只施加在正文上,结果三项报告均值全部低于基线。请把问题回答好,按社区自己的规则披露你的利益关系,并把“被选中”当作一件你去观察的事,而不是一件你能买来的事。

如果被引用的来源就是我的那条回复,答案说的就是我的观点吗?

并不可靠。Findings of EMNLP 2023 那份对生成式搜索的审计发现,只有 51.5% 的生成句子被引用完全支持,也只有 74.5% 的引用真的支持它所附的那句话。2026 年一篇预印本测得,AI Overview 里 98,020 条原子主张中有 11.0% 没有支持。请去读答案正文,而不是只看引用清单,并且要预期两者经常对不上,对不上才是常态。

一个帖子的引用变化要跑多少次才算真的?

比抽查要多得多。已有测量显示,在温度为零时重复运行会改变 9% 到 28% 的决策;另一项覆盖四个引擎、把同一批查询连跑 45 天的研究测得,相邻两天之间来源层面的重合度为 0.34 到 0.42。按 95% Wilson 区间算,五次运行大约是正负 33 个百分点,三十次是正负 17,两百次是正负 7。请按计划记录被引用的 URL,并为每一条记下产品、模式、日期、地区与账号。

Bavior 编辑部