首頁/學習 GEO/出現在 AI 搜尋中
AI 能見度 · 實戰手冊

如何出現在 AI 搜尋結果中?真正能改變答案的是什麼?

能不能出現,首先是供給問題,其次才是排名問題。三件事決定它:引擎能不能抓取到你;你發布的文件是否符合被提出的那個問題;以及你這個月交付的東西,有沒有改變其中任何一項。

本頁內容
分享本文
分享到 X 分享到 LinkedIn
簡短回答

要出現在 AI 搜尋結果中,先通過一道機械性的資格關卡,再把問題所需的證據形態,發布到引擎本來就會取材的地方。Google 把這道關卡講得很白:頁面必須被收錄,且有資格帶著摘要出現在 Google 搜尋中,此外「沒有額外的技術要求」。2 關卡之後的事也不是隨機的:在 602 條受控 prompt 與 21,143 條搜尋層引用中,官方、新聞與垂直三類來源合計佔了全部引用的 79.12% 到 87.52%,依平台而異。1

關鍵要點
  • 資格是機械性的,而且免費:被收錄、能被搜尋端爬蟲抓取、沒有多餘的摘要指令。
  • 引擎為不同工作執行不同的爬蟲,所以阻擋訓練用爬蟲,並不會把你從搜尋索引中移除。
  • 讓文件符合問題。在一項研究的影響力代理指標上,承擔比較工作的引用均值為 0.1524,僅作參照的引用為 0.0529。
  • 沒有任何平台的引用佔比穩定到可以拿來規劃:文獻報告的是來源重疊度低,以及每次執行之間的顯著波動。
  • 監測告訴你目前的位置。下面每一條槓桿都是一次發布或外展動作,所以光有儀表板什麼也推不動。
機制

AI 搜尋結果究竟從哪裡來?

來自索引、扇出與抓取,而其中只有第一步像傳統 SEO。Google 的文件寫明,它的 AI 功能「可能使用查詢扇出技術」,針對多個子主題與資料來源發出多條相關搜尋,所以使用者輸入的問題,很少就是檢索看到的那條查詢。2 底層的這些功能「根植於我們核心的搜尋排名與品質系統」。3

爬蟲層是兩套系統明顯分岔的地方,而這個拆分是引擎自己寫在文件裡的,不是推測出來的。OpenAI 用 GPTBot 取得訓練資料,用 OAI-SearchBot 讓網站出現在 ChatGPT 的搜尋功能中,並用 ChatGPT-User 開啟使用者要求 ChatGPT 打開的頁面,而這種情況下「robots.txt 規則可能不適用」。4 Perplexity 的文件描述了同樣的結構,其中由使用者觸發的抓取器「通常會忽略 robots.txt 規則」。5

爬蟲令牌文件載明的用途robots.txt
GPTBot可能用於訓練基礎模型的內容適用,屬於授權選擇
OAI-SearchBot讓網站出現在 ChatGPT 搜尋中適用,阻擋就會失去那些答案
ChatGPT-User開啟使用者要求的頁面可能不適用,由使用者發起
PerplexityBot搜尋與連結,不用於模型訓練適用
Perplexity-User使用者在 Perplexity 內的操作通常被忽略
Google-ExtendedGoogle 其他地方的 AI 訓練與接地獨立控制項,與搜尋資格無關

robots.txt 裡的一行,就可能把你從一個原本想保留的介面上移除。阻擋訓練用爬蟲,在搜尋上不必付出任何代價。阻擋搜尋端爬蟲則是一個能見度決定,而團隊常常本想做前者,卻不小心做成了後者。哪個令牌負責什麼,見爬蟲令牌

供給端

AI 引擎從哪三類來源取材?

目前最詳細的公開拆解,把它們標為官方、新聞與垂直;在那份資料集裡,這三類承擔了每個平台大部分的引用。1

87.52%佔 ChatGPT 引用三類來源合計
46.35%Google 的官方來源佔比最大的單一類別
31.17%ChatGPT 的新聞來源佔比它的第二大類別
21,143條搜尋層引用602 條 prompt,三個平台
來源類型ChatGPTGooglePerplexity
官方34.22%46.35%44.07%
新聞31.17%18.99%16.07%
垂直22.13%22.00%18.99%
合計87.52%87.34%79.12%
01

你擁有的頁面

在每個被測平台上都是最大的單一類別,也是唯一一類你今天下午就能發布進去的。它同時也是供給最不足的:價格、限制與遷移路徑,往往根本沒有發布在任何機器讀得到的地方。

02

你贏得的報導

在那份資料集裡,新聞佔 ChatGPT 引用的 31.17%,所以媒體報導是一條供給線,而不是虛榮指標。工作的單位是寫手能查證的東西:原創資料、基準測試、免費工具。

03

拿你做比較的文件

彙整文章、品類說明與社群討論串會同時描述好幾個被點名的選項,這正是候選清單類問題需要的形態。結構性原因在第三方頁面一文中有完整論證。

先讀標籤,再讀百分比。這些是該研究自己的分類,在單一時間窗內蒐集,而且表格沒有把社群平台單獨列成一列,所以「垂直」不是「論壇」的同義詞。1 經得起這層保留的是排序:你自己的網站在每個平台上都是最大的一類,其次是贏得的報導,剩下的由別人拿你做比較的文件承擔。三條生產線、三種前置時間,只跑其中一條的計畫,上限就是那一類的份量。

槓桿問題

Reddit 仍然是槓桿最高的曝光位置嗎?

對某一類很窄的問題來說,是的,而原因是文件形態,不是網域權威度。「大家實際上都用什麼來做 X」這種問題,要的是好幾個被點名的選項,各自附上親身經驗的理由。一個有二十個人憑經驗回答的討論串,是關於整個品類的比較形態證據。你的產品頁,則是關於單一選項的參照形態證據。

引用表格也是同一個走向:比較類引用共 1,719 條,影響力代理指標均值 0.1524,僅次於定義類的 0.1531,約為僅作參照類引用 0.0529 的三倍。在頁面層級,含比較內容的文件均值為 0.1389,不含的為 0.0894,寫作 +55.28%。作者形容高影響力頁面「富含可擷取的證據,例如定義、數值事實、比較和操作步驟」。1

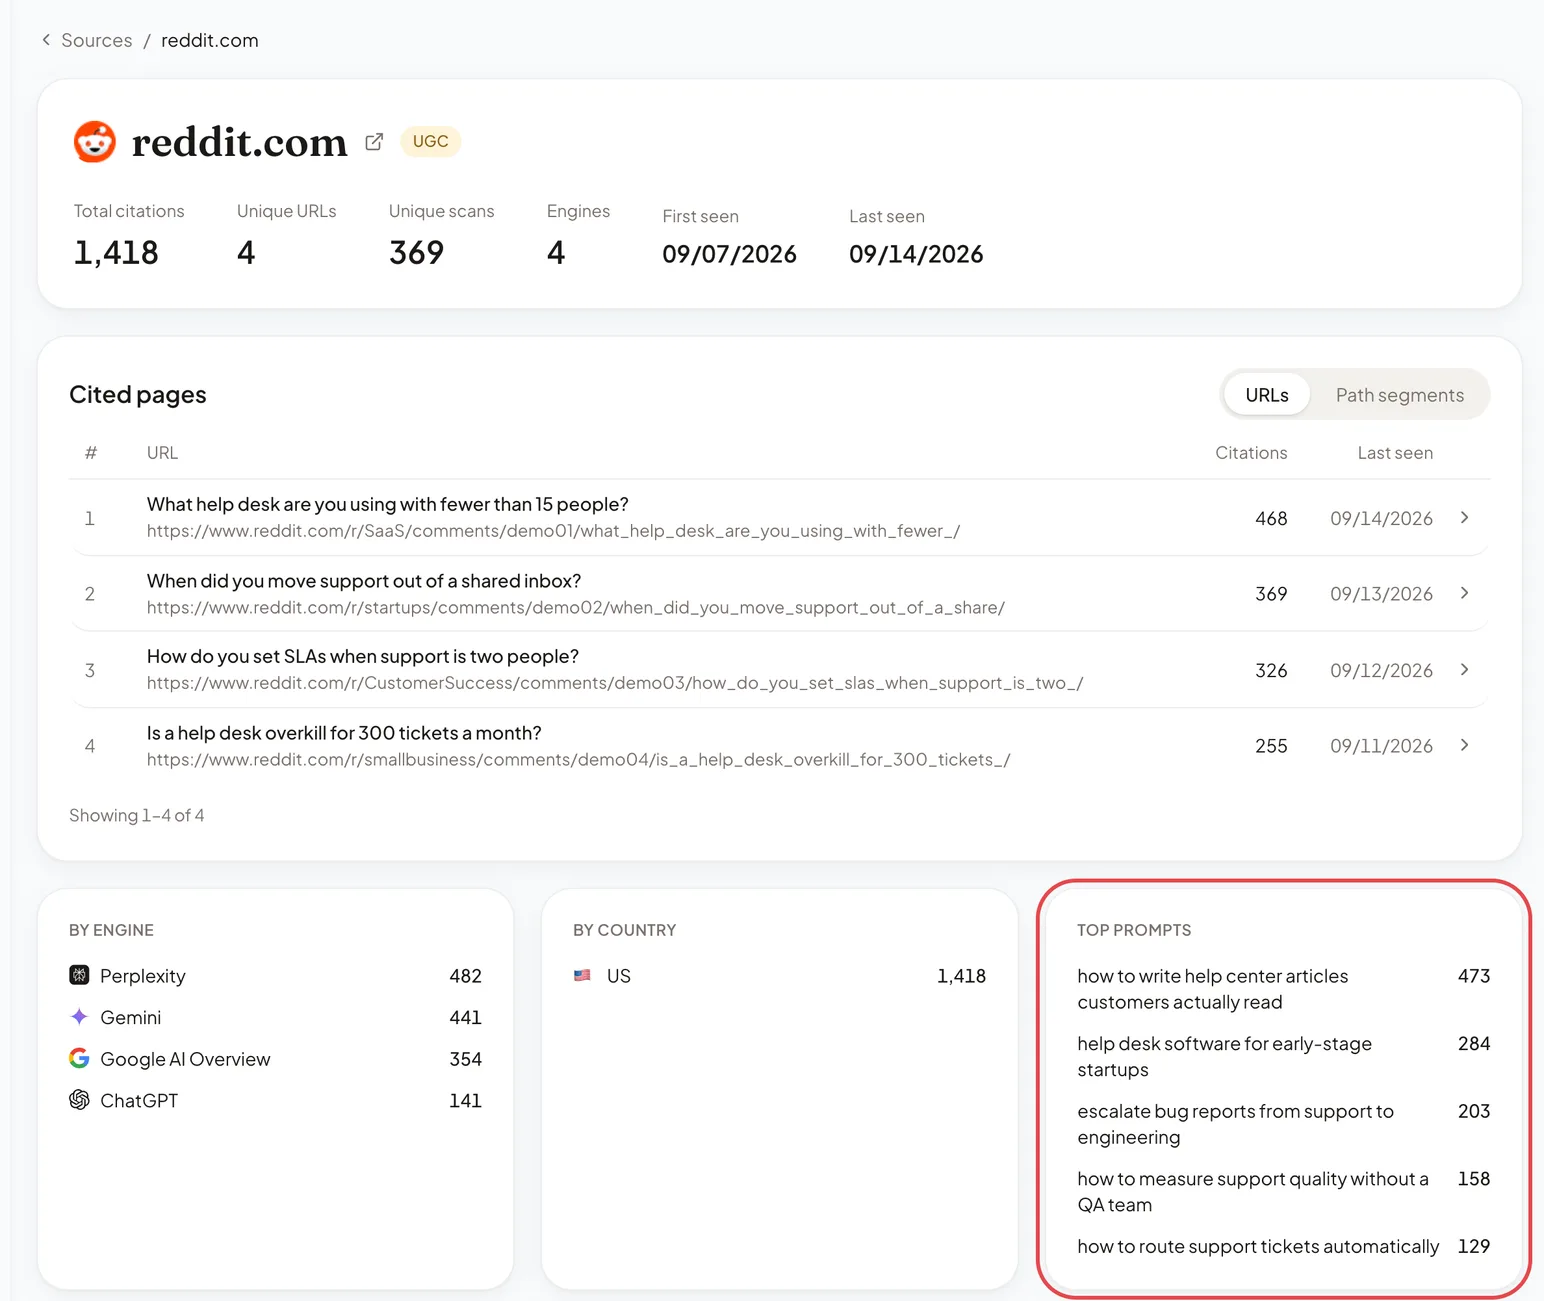
所以工作的單位是一個討論串加上一個問題,而不是一個網域,在任何地方發文之前,先把這兩樣找出來。在 Bavior 裡,從 Sources 打開 reddit.com:Cited pages 列出答案引用過的具體討論串,Top prompts 列出讓引擎引用它們的購買問題。去參與那些回答了你在意之問題的討論串,網站上其他地方就先略過。

Bavior source detail for reddit.com: total citations, the Reddit threads AI engines cited, citations by engine and country, and the top prompts that led to those citations
示範工作區中的範例資料。討論串標題僅為示意,並非真實的 Reddit 貼文。紅框標出的是 Top prompts,也就是這些引用背後的問題;其中的計數來自一組示範 prompt,並不是平台佔比。

槓桿到哪裡為止?到競爭為止,而這一點也被測量過。C-SEO Bench 發現「隨著採用 C-SEO 的人數增加,整體收益會下降」,並把這個問題稱為擁擠且零和的。8 社群平台除了這個特性,還多了一位版主:三家公司在做時有效的做法,到了三百家都在做,就會有人為它寫一條版規。凡是平台要求揭露商業關係的地方都要揭露,其餘部分見討論串如何入選

關於你看過的那個百分比

「Reddit 佔 ChatGPT 引用接近 40%」這類數字一直在流傳,而沒有任何經同儕審查的研究支持它。現有的測量都是商業面板,使用不同的分母,而我們在 2026 年 9 月 12 日核對過的那幾份,彼此之間的差距比任何人想測的效應還大。文獻說明了這為何在意料之中:各引擎在來源多樣性與穩定性上差異顯著,6 而那份批判性綜述也記錄到,商業審計中來源重疊度低、每次執行之間波動顯著。7 平台佔比是某一個面板在某個時間點的快照,任何計畫都不該建立在它上面。

在社群平台上值得做的事

  • 在已經針對你在意的問題排上名的討論串裡,憑實際營運經驗作答
  • 補上缺少的數字、價格、限制或遷移路徑,讓討論串變得可以被引用
  • 凡是版塊或平台有要求的地方,就揭露商業關係

不值得做的事

  • 在你從未參與過的討論串裡買一次提及
  • 把同一段比較文字貼到許多版塊,也就是 C-SEO Bench 測到的擁擠效應
  • 替某個平台的引用佔比設定目標,那是你既無法掌控、也無法重現的數字
其他幾條線

除了社群討論串,還有什麼能改變答案?

資格排第一,因為它是二元的,而陷阱就在同一份文件裡:摘要控制項 nosnippet、data-nosnippet 與 max-snippet,同樣決定 AI 功能可以從你的頁面顯示什麼。2 多年前為了保護付費牆而加上的一條指令,可能正是你始終沒出現的原因。

結構化資料是團隊下一個容易過度投入的地方,而 Google 說得罕見地直接:「生成式 AI 搜尋不需要結構化資料,也沒有你需要加上的特殊 schema.org 標記」。3 標記的價值,在於讓那些會讀取它的功能能乾淨地解析頁面。它不是決定答案會不會引用你的槓桿,預算也該照這個定位來編。

為了贏得引用而改寫頁面,是這裡最常見的失敗,而且已被測過兩次。C-SEO Bench 報告,多數對話式 SEO 方法「不僅大多無效,而且經常對文件排名產生負面影響」。8 那份涵蓋 45 項研究的綜述也落在同一個地方:相關性與上下文位置是最可重現的槓桿,而以引用為導向的改寫可能損害檢索。7 一個被改寫成好引用的答案、卻因此掉出檢索池的頁面,輸掉的是唯一重要的那一輪。

先修好資格,其他都往後排

被收錄、能被每個搜尋端令牌抓取、沒有多餘的摘要指令。完整順序見技術檢查清單

發布證據,而不是形容詞

定義、數字、比較與操作步驟得分最高。一段從頁面中被單獨摘出後仍然成立的文字,勝過一整節只有放在原處才讀得通的內容。

贏得陌生人也能查證的提及

原創資料、公開基準或免費工具,能讓寫手有東西可引用,也讓引擎多了一份點名你的文件。

更正已經在描述你的頁面

一份還寫著你舊價格的彙整文章,會持續把這個錯誤餵進答案裡。更正它的回報最快。先從你的品類在哪裡被引用開始。

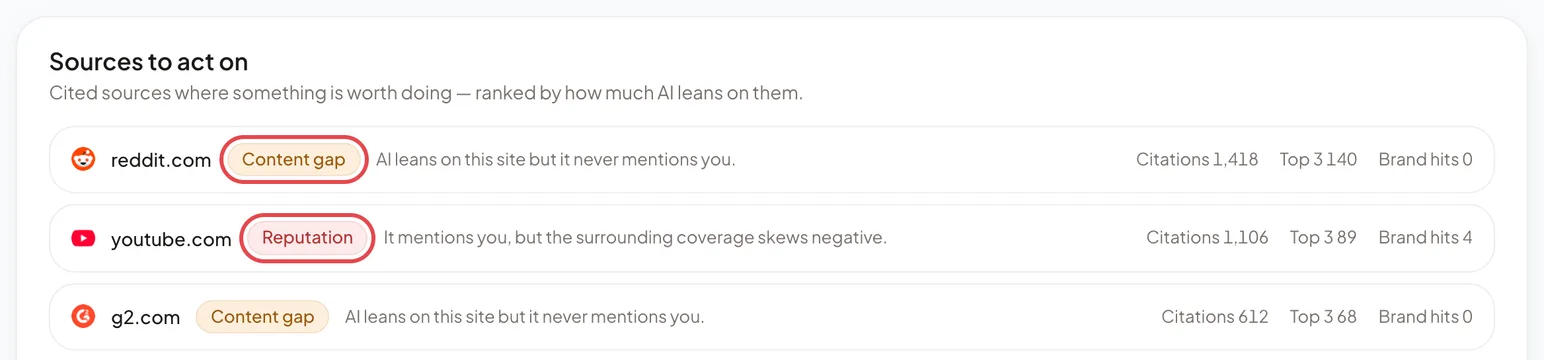
要執行最後這一步,在 Bavior 裡打開 Sources,逐列看 Sources to act on 上的標籤,因為同一個被引用的來源,可能需要截然相反的工作。Content gap 表示答案引用了它,但它從未提到你,這是上面幾條供給線的工作;Reputation 表示它提到了你,但報導偏向負面,而更正那些已經在描述你的頁面,就從這一列開始。

Bavior Sources to act on list: three domains AI answers cite, labelled Content gap or Reputation, with citations, Top 3 placements and brand hits
示範工作區中的範例資料。紅框:兩個行動標籤。
監測對上執行

為什麼多數 AI 能見度工具只解決了一半的問題?

因為測量與供給是兩份不同的工作,而只有其中一份能乾淨地變成圖表。監測產品會執行一組 prompt、記錄每則答案引用了哪些來源,再畫出趨勢。這項工作是必要的,不是裝飾:那份批判性綜述對商業審計的總結是來源重疊度低、每次執行之間波動顯著、忠實度落差持續存在,7 而 ACL 那份把五個生成式系統與 Google 自然搜尋對比的研究指出「各引擎在依賴內部還是外部知識、來源多樣性與穩定性上存在顯著差異」。6 沒有重複執行,你就無法把變化與噪聲分開。

圖表做不到的事是發布。本頁的每一條槓桿,最後都落在某個人要寫的文件、某個人要移除的指令,或某個人要回答的討論串上。那份綜述用一句話定下上限:已被檢索到的內容能以因果方式改變自己被引用或被使用的情況,但沒有任何一項被審閱的技術,對自然可發現性展現出穩定、縱向、跨平台的因果效應。7 在文件上下功夫,透過重複執行來測量,並預期這個測量本身是有噪聲的。

有一個問題能把這個品類的兩半分開:用了某個工具一週之後,儀表板以外有什麼改變了?如果答案是一份 prompt 清單和一封提醒摘要,那這個工具解決的是報表,這件事確實很難,也值得花錢。它只是不是讓你被引用的那一半。

30 天計畫

一份 30 天的 AI 能見度計畫長什麼樣?

四週,每週一件事,外加一項能證明它確實落地的檢查。不需要預算,也不承諾任何引用。

時段要做的事什麼能證明它落地了
第 1 到 7 天資格審計:收錄狀況、逐一檢查 robots.txt 的每個令牌、移除多餘的摘要指令。日誌中出現你放行的每個令牌的造訪紀錄,關鍵頁面上沒有 nosnippet。
第 8 到 14 天基線:20 到 30 個真實的購買問題,每題跑三次,記下每一個被引用的 URL。一張表、60 到 90 次執行,分成你擁有的、描述你的、忽略你的三類頁面。
第 15 到 21 天補上基線找到的缺口:比較、價格與限制、操作步驟。三個頁面上線,每頁都有一段能獨立回答某個已記錄問題的文字。
第 22 到 30 天站外與重新測量:回答兩個討論串、更正一個把你寫錯的頁面、重跑同一組問題。被引用 URL 清單的前後差異,當作方向來讀,而不是證明。
這份計畫誠實的邊界

三十天足以修好資格、建立基線並交付三份文件。但不足以證明因果,而且至今沒有任何單一技術展現出持久的跨平台效應。7 可以期待的是一份乾淨的機械性審計、一套可重複的測量,以及一條以前不存在的供給線。不要期待一個只會往上走的數字:來源組成是照引擎的時程在變動,不是照你的。

產品派得上用場的地方,和派不上的地方

上面前兩週的工作,刻意設計成免費且手動。真正會撐不住的是第五週:那時這組問題得按排程重跑,而值得回答的討論串冒出來的速度,比任何人讀得完的速度還快。Bavior 按排程在多個引擎上重跑一組固定的 prompt,並記錄每則答案引用了哪些來源;當被引用的來源是一個仍在進行的討論時,它會在你掌控的帳號上,用你的語氣草擬回覆。未經你審核,不會發布任何內容,無論是用 Bavior 的老帳號還是你自己的帳號。它無法購買版位、無法談成收錄,也無法讓任何引擎引用你。方案每月 $99 起,相比之下代理商的月費行情是每月 $3,000 到 $20,000。¹

出處,全部核查於 2026 年 9 月 12 日
  1. Zhang Kai、He Xinyue、Yao Jingang,《From Citation Selection to Citation Absorption》,2026 年 4 月 28 日(v2 為 2026 年 4 月 29 日),arXiv:2604.25707(描述性預印本,公開的 geo-citation-lab 資料集);602 條 prompt、21,143 條搜尋層引用、18,151 個抓取頁面;來源類型表、語意角色表與證據體裁表:arxiv.org/abs/2604.25707
  2. Google Search Central,《AI features and your website》,最後更新於 2025 年 12 月 10 日;第一方文件(查詢扇出、摘要資格、摘要控制項):developers.google.com/search/docs/appearance/ai-features
  3. Google Search Central,《Google’s Guide to Optimizing for Generative AI Features on Google Search》,最後更新於 2026 年 7 月 10 日;第一方文件(不需要結構化資料):developers.google.com/search/docs/fundamentals/ai-optimization-guide
  4. OpenAI,《Bots》,爬蟲文件,核查於 2026 年 9 月 12 日;第一方文件(GPTBot/1.4、OAI-SearchBot/1.4、ChatGPT-User/1.0):developers.openai.com/api/docs/bots
  5. Perplexity,《Bots》,爬蟲文件,核查於 2026 年 9 月 12 日;第一方文件(PerplexityBot、Perplexity-User):docs.perplexity.ai/guides/bots
  6. Kirsten 等,《Characterizing Web Search in The Age of Generative AI》,Findings of ACL 2026,pp. 10827–10848;三家供應商的五個生成式系統,對比 Google 自然搜尋:aclanthology.org/2026.findings-acl.526
  7. Olivier Martinez,《Optimizing Visibility in Generative Engines: A Critical Survey (2023–2026)》,2026 年 7 月 15 日,arXiv:2607.14035(綜述預印本);45 項研究,2023 年 11 月至 2026 年 7 月:arxiv.org/abs/2607.14035
  8. Puerto 等,《C-SEO Bench: Does Conversational SEO Work?》,NeurIPS 2025 Datasets & Benchmarks Track,arXiv:2506.11097(v1 為 2025 年 6 月 6 日,v3 為 2025 年 10 月 20 日);十種方法、兩類任務、各三個領域:arxiv.org/abs/2506.11097
常見問題

你想知道的,都在這裡。

要多久才能出現在 AI 搜尋結果中?

資格方面的修正,生效速度和重新抓取一樣快,通常是幾天。被引用則更慢、噪聲也更大,因為同一個問題每次執行的答案都會不同。可以這樣規劃:一週內完成機械性修正,兩週內建立基線,固定的 prompt 集合至少重複跑三次之後,才讀得出方向。

要出現在 AI 搜尋結果中,一定要做 schema 標記嗎?

不用。Google 自己的指引寫明,生成式 AI 搜尋不需要結構化資料,也沒有需要額外加上的特殊 schema.org 標記。標記對那些會使用它的搜尋功能仍然有用,所以把它當成預算不多的解析整理工作,而不是影響引用的槓桿。

阻擋 GPTBot 會把我從 ChatGPT 搜尋結果中移除嗎?

不會。OpenAI 的文件為不同工作列出不同的令牌:GPTBot 抓取的是可能用於訓練基礎模型的內容,而讓網站出現在 ChatGPT 搜尋功能中的是 OAI-SearchBot。阻擋前者是授權選擇。阻擋後者,才會讓你從那些答案中消失。

有沒有任何工具能保證 AI 引擎引用我的品牌?

沒有,而聲稱能做到的廠商,描述的是沒有人證明過的東西。這個領域已發表的綜述指出,沒有任何一項被審閱的技術,對可發現性展現出穩定、跨平台的因果效應。能買到的,是更快的測量,以及更快地供給答案可能取材的文件。

Bavior 編輯部

負責研究與維護 Bavior 關於 Reddit 行銷和 AI 搜尋可見度的所有內容。文中每一個數字都註明了來源出處與查證日期,所有外部連結均非聯盟推廣連結。

發現數字有誤?告訴我們,我們會重新查證:support@bavior.com

你沒辦法把儀表板發布進 AI 答案裡。
找出你的品類是從哪些頁面和討論串被引用的。

免費試用