1 從被引用的 URL 出發,而不是從版塊規模出發 寫下買家真的會輸入的十個問題,在你在意的每個引擎上各跑一遍,記下答案引用的每一個 URL。這份通常接近十五個 URL 的清單,就是你的工作集。
2 先讀討論串,再看版塊 依序檢查三件事:這個討論串是否仍開放回覆;它提出的問題,你能不能用具體的內容回答;以及這個版塊是否允許有商業利益的人回覆。
3 回答對方實際提出的問題 會被引述的回覆,帶著一個限制條件、一個數字和一條邊界:你測了什麼、在什麼上面測,以及它在哪裡不再成立。讀起來像在替品牌卡位的那個版本,會先被版主刪掉。
4 社群要求揭露時,就揭露關係 凡是版塊或平台要求揭露商業關係的地方,揭露就是必須的;這項義務不會因為一部分受眾是檢索系統而減輕。
5 重跑同一組 prompt,觀察集合的變動 引用集合並不穩定,所以三月時撐起某則答案的討論串,到了九月可能什麼都撐不起。按排程重跑那組固定的 prompt,並停止在已經掉出去的討論串上投入。
第一步正是最常被跳過的一步,而跳過它是這裡代價最高的錯誤。按規模挑社群,得到的是一份人氣排行;而引擎檢索到的討論串,是依照「是否符合某個問題」被選出來的,這兩份清單的重疊程度遠比任何人預期的低。在一個從未被引用過的討論串裡寫出一則有用的回覆,換到的是好感,而不是引用,而且沒有任何東西會告訴你它失敗了。
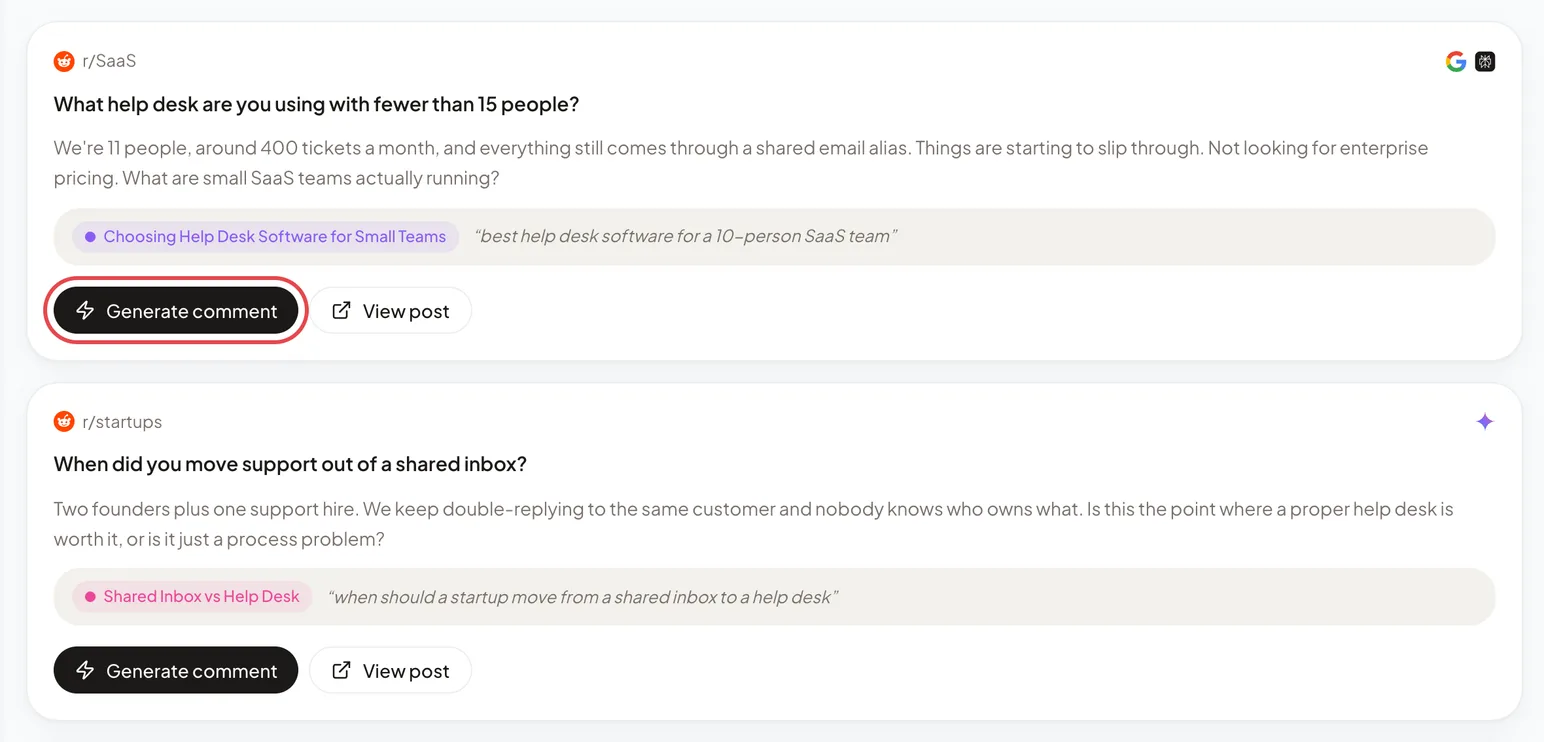
第一步和第二步可以手動完成,用一張試算表記下 prompt 和每則答案引用的 URL 即可;Bavior 則把找出這些討論串、草擬並審核回覆,放進同一個佇列。打開 Action Opportunities :每張卡片都是一個 AI 引擎已經在引用的討論串,附上它所屬的版塊,以及讓它浮現的主題與 prompt。先用 View post 做第二步的檢查,再按 Generate comment 。
示範工作區中的範例資料。討論串標題僅為示意,並非真實的 Reddit 貼文。紅框標出的是 Generate comment,它產生的是一份等你審閱的草稿,而不是一則貼文。
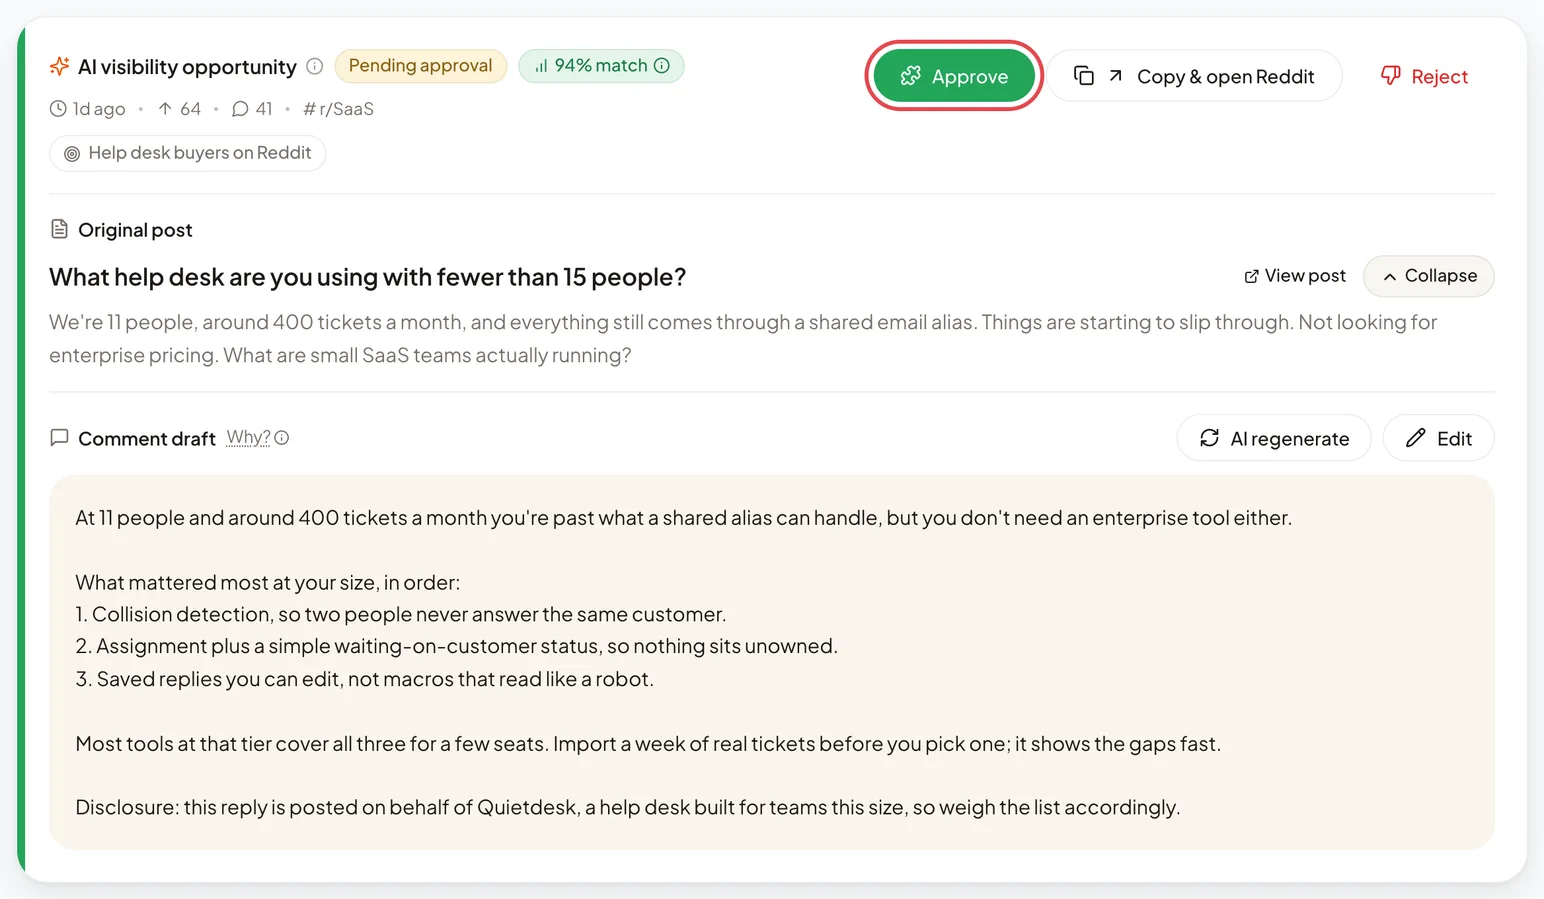
草稿會在 Pending approval 底下等待。對照第三步和第四步逐一檢查:它是否在發文者給出的限制內作答?是否依版塊要求,揭露了這則回覆是替誰發的?用 Edit 修改,直到兩項都成立。按 Approve 會交給真人操作員,用 Bavior 提供的帳號發出;Copy & open Reddit 則是用你自己的帳號發文。
示範工作區中的範例資料。討論串標題僅為示意,並非真實的 Reddit 貼文。這份草稿針對的是上方第一張卡片裡的同一個討論串;紅框標出的是 Approve,沒有它,Bavior 什麼都不會發出。
有一個預期必須誠實交代,因為這條建議的流行版本默認了它。一則被按讚的回覆不會變成引用。它只是成為某個討論串的一部分,而這個討論串可能會、也可能不會在你在意的查詢上被檢索到;至於引擎會不會發出那條查詢,並不由你決定。本文能查證的研究中,沒有任何一份把讚數、留言深度或帳號年齡當作引用選擇的輸入來測量。