首页/学习 GEO/出现在 AI 搜索里
AI 可见性 · 实操手册

如何才能出现在 AI 搜索结果里?真正改变答案的是什么?

「被看见」首先是供给问题,其次才是排名问题。三件事决定它:引擎能不能抓到你;你发布的那份文档,是否匹配被提出的那个问题;以及你这个月交付的东西,有没有改变前两者中的任何一个。

本页目录
分享本文
分享到 X 分享到 LinkedIn
直接回答

想出现在 AI 搜索结果里,先过一道机械的资格闸门,然后把「这个问题所需要的证据形态」发布到引擎本来就会取用的地方。Google 把这道闸门写得很直白:页面必须被收录,并且有资格带摘要出现在 Google 搜索里,除此之外「没有额外的技术要求」。2闸门之后同样不是随机的:在 602 条受控提示、21,143 条搜索层引用的统计里,官方、新闻与垂直三类来源合计占据 79.12% 到 87.52% 的引用,具体比例随平台而不同。1

关键要点
  • 资格是机械的,而且不花钱:被收录、能被搜索侧爬虫抓取、没有多余的摘要指令。
  • 各家引擎为不同任务跑不同的爬虫,所以屏蔽训练爬虫并不会把你从搜索索引里移除。
  • 让文档形态匹配问题形态:在答案里承担比较职能的引用,在影响力代理指标上均值 0.1524,而只作参考的引用是 0.0529。
  • 没有任何平台的引用占比稳定到可以拿来做计划:文献报告了来源重合度低,以及显著的运行间波动。
  • 监测告诉你当下站在哪里。下面每一条杠杆都是一次发布或一次外联动作,光有仪表盘什么也推不动。
机制

AI 搜索结果究竟从哪里来?

来自索引、扇出与抓取,而其中只有第一步长得像传统 SEO。Google 的文档写明,其 AI 功能「可能使用查询扇出(query fan-out)技术」,围绕子主题与数据源发起多次相关检索,所以人类敲下的那个问题,往往不是检索真正看到的查询。2底下的这些功能「植根于我们核心的搜索排序与质量系统」。3

爬虫层是两套系统肉眼可见的分岔点,而这种拆分是引擎自己写在文档里的,不需要靠猜。OpenAI 用 GPTBot 取训练数据,用 OAI-SearchBot 把站点呈现到 ChatGPT 的搜索功能里,用 ChatGPT-User 抓取用户要求 ChatGPT 打开的页面,文档写着此处「robots.txt 规则可能不适用」。4Perplexity 记录了同样的结构,而它由用户触发的抓取器「通常会忽略 robots.txt 规则」。5
爬虫 token文档写明的用途robots.txt
GPTBot可能用于训练基础模型的内容适用,屏蔽是授权选择
OAI-SearchBot把站点呈现在 ChatGPT 搜索里适用,屏蔽即失去那些答案
ChatGPT-User打开用户指定要看的页面可能不适用,由用户发起
PerplexityBot搜索与链接,不用于模型训练适用
Perplexity-UserPerplexity 内的一次用户操作通常被忽略
Google-ExtendedGoogle 另一些系统中的 AI 训练与接地独立开关,不是搜索资格

robots.txt 里的一行,就可能把你从一个你本想保留的呈现面上抹掉。屏蔽训练爬虫是授权决定,在搜索上不付代价;屏蔽搜索侧爬虫是可见性决定,而团队常常是在想做前者时顺手做成了后者。哪个 token 对应哪件事,见哪些爬虫 token 值得关注

供给侧

AI 引擎主要从哪三类来源取用?

目前最细的公开拆解把它们标为官方、新闻与垂直,而在那份数据里,这三类占了每个平台的大部分引用。1

87.52%ChatGPT 的引用占比三类来源合计
46.35%Google 的官方类占比最大的单一类别
31.17%ChatGPT 的新闻类占比它的第二大类别
21,143条搜索层引用602 条提示,三个平台
来源类型ChatGPTGooglePerplexity
官方34.22%46.35%44.07%
新闻31.17%18.99%16.07%
垂直22.13%22.00%18.99%
合计87.52%87.34%79.12%
01

你自己拥有的页面

在被测的每个平台上,它都是最大的单一类别,也是唯一一类你今天下午就能往里发布的。它同时供给最不足:价格、限制与迁移路径,常常压根没发布在任何机器读得到的地方。

02

你赢得的外部报道

在那份数据里,新闻类占 ChatGPT 引用的 31.17%,所以编辑部报道是一条供给线,不是虚荣指标。它的工作单元是作者能核实的东西:原创数据、公开基准、免费工具。

03

拿你做比较的文档

榜单、品类科普与社区帖子会一次描述若干个被点名的选项,这正是候选清单类问题需要的形态。结构性原因见为什么第三方页面占优

先读标签,再读百分比。这些是该研究自己的分类,在一个时间窗内跨 ChatGPT、Google 与 Perplexity 采集,而且表里并没有把社区平台单列成一行,所以「垂直」不等于「论坛」。1经得起这层保留的是次序:你自己的站点在各处都是最大的一类,其次是你赢得的报道,剩下的由「别人比较你」的文档承担。三条生产线,三种交付周期;只跑其中一条的项目,天花板就是那一类的体量。

杠杆问题

Reddit 还是杠杆最高的落点吗?

对于一类很窄的问题,是的;而原因在于文档形态,不在于域名权重。形如「大家实际都在用什么来做 X」的问题,要的是若干个被点名的选项,每个都附着亲历过的理由。一个二十人凭经验作答的帖子,是关于整个品类的「比较形态」证据;而你的产品页,无论写得多好,都是关于单一选项的「参考形态」证据。

引用数据指向同一方向。在那份 21,143 条引用的拆解里,承担比较职能的引用共 1,719 条,影响力代理指标均值 0.1524,仅次于定义类的 0.1531,约为只作参考类 0.0529 的三倍;页面层面,含比较内容的文档均值 0.1389,不含的是 0.0894,记为 +55.28%。作者对高影响力页面的描述是:「富含可提取的证据,例如定义、数值事实、比较与操作步骤」。1

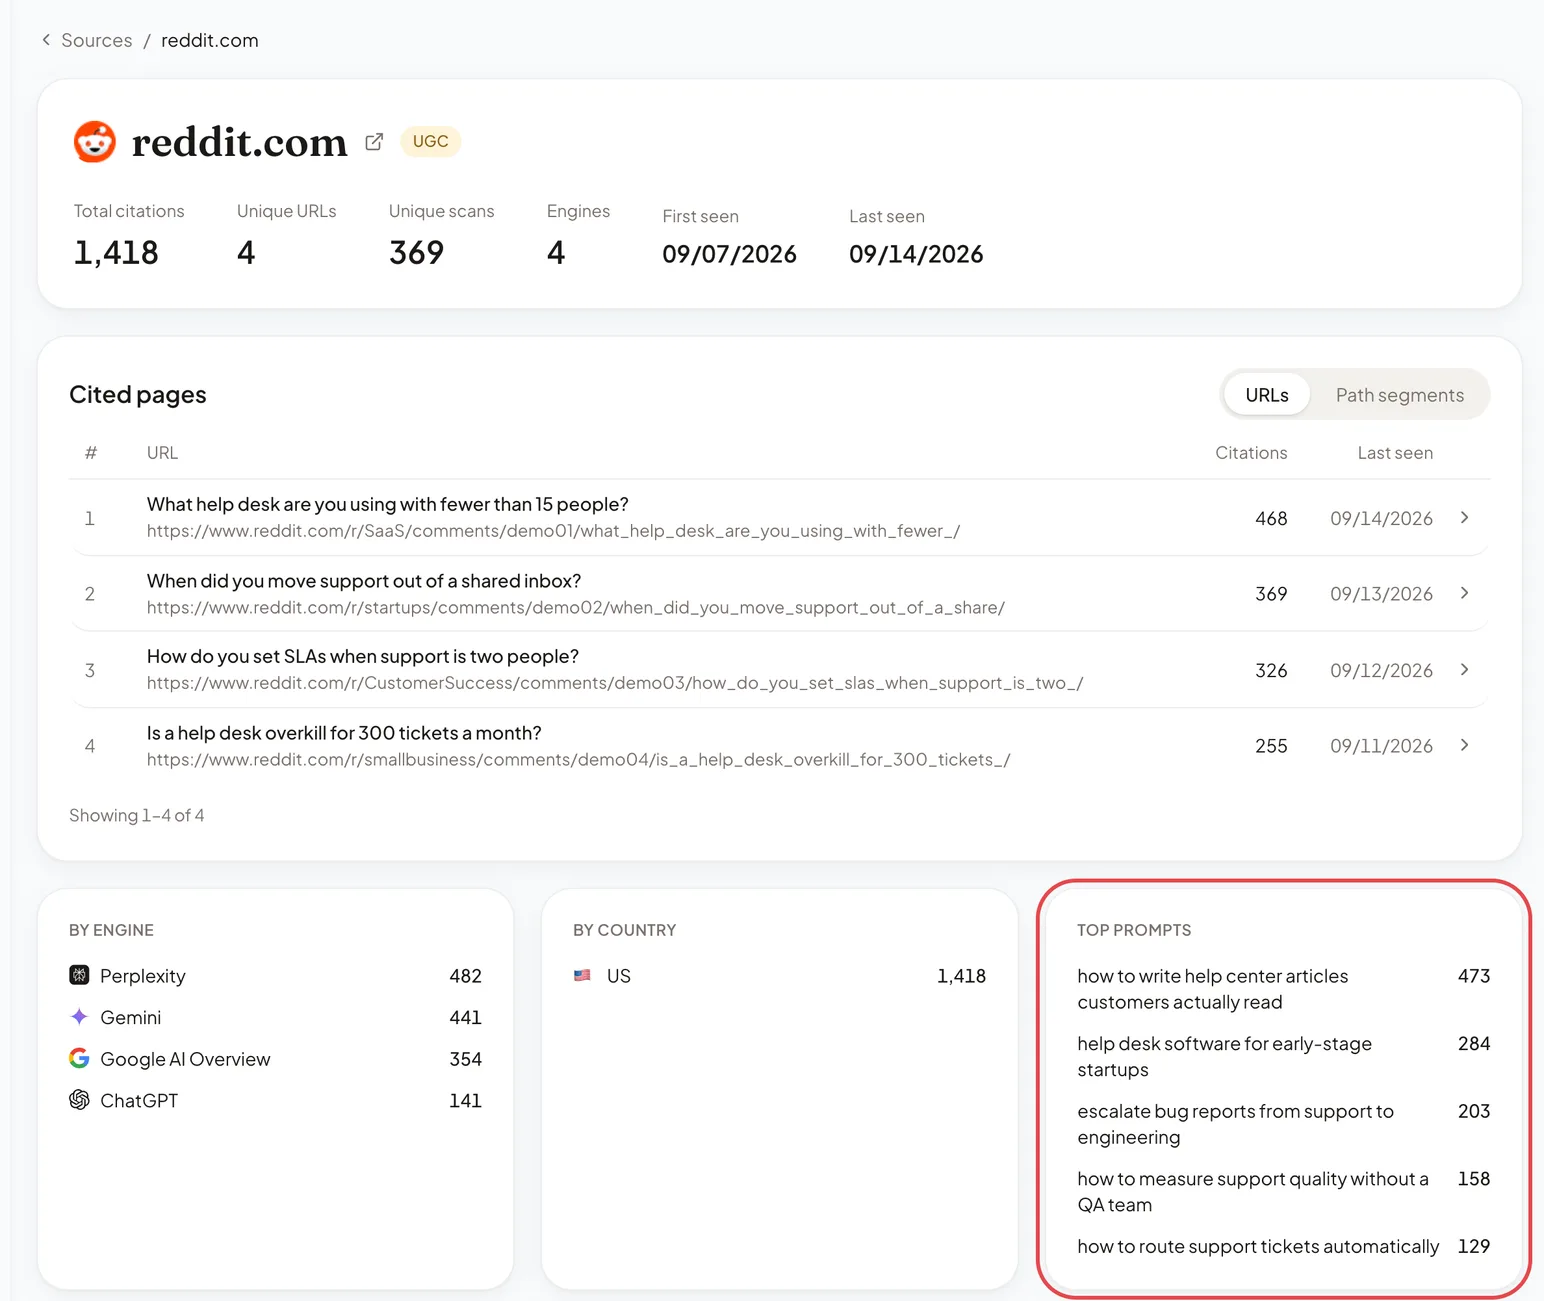
所以工作单元是一个帖子加一个问题,而不是一个域名;动笔之前先把这两样找出来。在 Bavior 里,从 Sources 打开 reddit.com:Cited pages 列出答案引用过的具体帖子,Top prompts 列出让引擎引用它们的购买问题。去参与那些回答了你在意的问题的帖子,站内其余地方先放着。

Bavior source detail for reddit.com: total citations, the Reddit threads AI engines cited, citations by engine and country, and the top prompts that led to those citations
演示工作区中的示例数据。帖子标题仅为示意,并非真实的 Reddit 帖子。红框标出的是 Top prompts,即这些引用背后的问题;其中的计数来自一组演示提示,不代表任何平台占比。

杠杆到哪里为止?是竞争,而这件事也被测过。C-SEO Bench 发现「随着采用 C-SEO 的参与者增多,整体收益递减」,并称这个问题拥挤且零和。8社区平台除此之外还多一位版主:三家公司做时有效的做法,等到三百家都做,就会变成一条新写进去的版规。凡是平台要求披露商业关系的地方就照做,其余部分见社区帖子是如何被选中的

关于你见过的那个百分比

「Reddit 占 ChatGPT 引用约 40%」一直在流传,而没有任何同行评议研究支持它。真正存在的测量来自商业面板,它们的分母并不相同,而我们在 2026 年 9 月 12 日核对过的这些面板彼此不一致,差距大于任何人想测的那个效应本身。文献解释了这为何是意料之中:各引擎在来源多样性与稳定性上差异显著,6那份批判性综述也记录了商业审计中普遍的来源重合度低与显著的运行间波动。7平台占比是某个面板某一天的快照,任何计划都不该建在它上面。

在社区平台上值得做的

  • 在已经能排到你在意那个问题的帖子里,凭运营经验作答
  • 把缺失的那个数字补上:价格、限制或迁移路径,让帖子变得可被引用
  • 凡是子版块或平台要求披露商业关系的地方,都照做披露

不值得做的

  • 在你从未参与过的帖子里买一次提及
  • 把同一段比较文案贴到许多子版块,这正是 C-SEO Bench 测到的拥挤效应
  • 为某个平台的引用占比设定目标,那是你既不掌控、也无法复现的数字
其他几条线

除了社区帖子,还有什么能改变答案?

资格排在最前面,因为它是二值的;而陷阱就在同一段文档里:nosnippet、data-nosnippet 与 max-snippet 这些摘要控制项,同样约束 AI 功能能从你的页面展示什么。2多年前为保护付费墙加上的一条指令,可能就是你始终不出现的全部原因。

结构化数据是团队第二容易过度投入的地方,而 Google 的说法罕见地直白:「生成式 AI 搜索并不要求结构化数据,也没有需要你添加的专用 schema.org 标记」。3标记的价值,在于为那些确实会消费它的功能做好解析卫生;它不决定答案会不会引用你,预算也该照此分配。

「为了赢得引用而重写页面」是这里最常见的失败,而且被测过两次。C-SEO Bench 报告,多数对话式 SEO 方法「不仅在很大程度上无效,而且经常对文档排序产生负面影响」。8那份涵盖 45 项研究的综述落在同一处:主题相关性与上下文位置是最可复现的杠杆,而面向引用的重写可能损害检索。7一个被改写成「好引用」却因此掉出检索池的页面,输掉的是唯一重要的那一轮。

先修资格,其他都往后排

被收录、能被每个搜索侧 token 抓取、承载论点的页面上没有多余的摘要指令。完整顺序见技术 GEO 检查清单

发布证据,而不是形容词

定义、数字、比较与操作步骤,是得分最高的几类证据形态。一段被整段摘走仍然成立的文字,胜过一整节离开上下文就散架的内容。

赢得陌生人可核实的提及

原创数据、公开基准或一个免费工具,能给作者一个可引用的对象,也给引擎多一份点名你的文档。

纠正那些已经在描述你的页面

一份写着你旧价格的榜单,会持续把这个错误喂进答案里。纠正它回报最快,却最没人排期。可以从你的品类在哪里被引用开始。

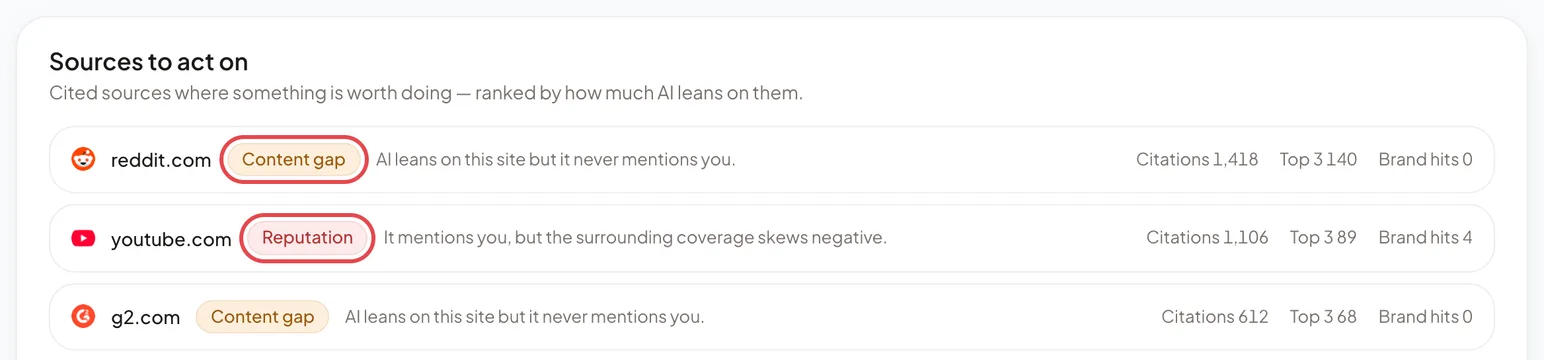
要做最后这一步,就在 Bavior 里打开 Sources,逐行看 Sources to act on 上的标签,因为同样是被引用的来源,要做的事可能截然相反。Content gap 表示答案引用了它,但它从未提到你,这是上面几条供给线要做的活;Reputation 表示它提到了你,但周边报道偏负面,修正那些已在描述你的页面,就从这一行开始。

Bavior Sources to act on list: three domains AI answers cite, labelled Content gap or Reputation, with citations, Top 3 placements and brand hits
演示工作区中的示例数据。红框:两个行动标签。
监测与执行

为什么多数 AI 可见性工具只解决了一半问题?

因为测量和供给是两件不同的活,而只有其中一件能干净地变成图表。监测产品跑一组提示、记录每个答案引用了哪些来源、再画出趋势。这项工作是必要的,不是装饰:那份批判性综述对商业审计的总结是来源重合度低、运行间波动显著、事实还原度长期有缺口,7而 ACL 那篇把 Google 自然搜索与五个生成式系统做对比的论文写道:「各引擎在依赖内部知识还是外部知识、来源多样性与稳定性上存在显著差异」。6没有重复运行,你无法把真实变化和噪声分开。

图表做不到的事是发布。本页每一条杠杆,最终都落到某个人要写的文档、某个人要删掉的一条指令、或者某个人要用版主愿意接受的语气去回答的一个帖子上。综述用一句话给整个领域画了上限:已被检索到的内容确实能因果性地改变自己被引用或被使用的情况,但被审阅的技术里没有任何一种展示出对自然可发现性或下游行为的稳定、纵向、跨平台因果效应。7对文档动手,用重复运行测结果,并预期这个测量本身就是嘈杂的。

有一个问题能把这个品类的两半分开:用了一周之后,仪表盘之外发生了什么变化?如果答案是一份提示列表、一条声量曲线和一封告警摘要,那它解决的是报告,而供给问题还躺在某个人的待办里。报告那一半确实很难,也值得花钱买;它只是不是让引擎引用你的那一半。

30 天计划

一份 30 天 AI 可见性计划长什么样?

四周,每周一件事,外加一项能证明它确实落地的检查。不需要预算,也不承诺任何一次引用。

时间窗要做的事什么能证明它落地了
第 1 到 7 天资格审计:收录情况、逐个 token 检查 robots.txt、清掉多余的摘要指令。日志里,你放行的每个 token 都有到访记录,关键页面上没有 nosnippet。
第 8 到 14 天建基线:20 到 30 个真实购买问题,每题跑三轮,记录每一条被引用的 URL。一张表,60 到 90 次运行,按「你拥有的/描述你的/没提你的」页面分好类。
第 15 到 21 天补上基线发现的空缺:比较、价格与限制、操作步骤。三个页面上线,每个都含一段能独立回答某个已记录问题的文字。
第 22 到 30 天站外与复测:回答两个帖子,纠正一份把你写错的页面,再把同一组提示原样跑一遍。被引用 URL 列表的差异,读成方向,而不是证明。
这份计划诚实的边界

三十天足够修好资格、建起基线、交付三份文档;但不足以证明因果,而且至今没有任何单一技术展示出可持续的跨平台效应。7你该期待的是:一份干净的机制审计、一套可复现的测量方法,以及一条此前并不存在的供给线。你不该期待的,是一个只会向上走的数字,因为来源构成按引擎的时间表移动,不按你的。

产品用在哪里,以及不用在哪里

上面的前两周,是刻意设计成免费且手动的。真正会崩掉的是第五周,当提示集需要按排期反复重跑、而值得回复的帖子出现得比任何人读得完还快的时候。Bavior 会按排期在多个引擎上重跑一组固定提示,记录每个答案引用了哪些来源;当被引用的来源是一场活跃讨论时,它会用你的语气、在你掌控的账号上起草一条回复。任何内容都不会在你批准之前发布,无论用 Bavior 的老账号还是你自己的账号。它无法购买位置、无法谈成收录,也不能让任何引擎引用你。套餐从 $99/mo 起,而代理机构的行情是每月 $3,000 到 $20,000。¹

来源,全部核对于 2026 年 9 月 12 日
  1. Zhang Kai、He Xinyue、Yao Jingang,《From Citation Selection to Citation Absorption》,2026 年 4 月 28 日(v2,4 月 29 日),arXiv:2604.25707(描述性预印本,公开 geo-citation-lab 数据集);602 条提示、21,143 条搜索层引用、18,151 个抓取页面;含来源类型表、语义角色表与证据体裁表:arxiv.org/abs/2604.25707
  2. Google Search Central,《AI features and your website》,最后更新 2025 年 12 月 10 日;一手(查询扇出、摘要资格、摘要控制项):developers.google.com/search/docs/appearance/ai-features
  3. Google Search Central,《Google’s Guide to Optimizing for Generative AI Features on Google Search》,最后更新 2026 年 7 月 10 日;一手(不要求结构化数据):developers.google.com/search/docs/fundamentals/ai-optimization-guide
  4. OpenAI,《Bots》爬虫文档,核对于 2026 年 9 月 12 日;一手(GPTBot/1.4、OAI-SearchBot/1.4、ChatGPT-User/1.0):developers.openai.com/api/docs/bots
  5. Perplexity,《Bots》爬虫文档,核对于 2026 年 9 月 12 日;一手(PerplexityBot、Perplexity-User):docs.perplexity.ai/guides/bots
  6. Kirsten 等,《Characterizing Web Search in The Age of Generative AI》,Findings of ACL 2026,第 10827–10848 页;把三家提供方的五个生成式系统与 Google 自然搜索做对比:aclanthology.org/2026.findings-acl.526
  7. Olivier Martinez,《Optimizing Visibility in Generative Engines: A Critical Survey (2023–2026)》,2026 年 7 月 15 日,arXiv:2607.14035(综述预印本);45 项研究,覆盖 2023 年 11 月至 2026 年 7 月:arxiv.org/abs/2607.14035
  8. Puerto 等,《C-SEO Bench: Does Conversational SEO Work?》,NeurIPS 2025 Datasets & Benchmarks Track,arXiv:2506.11097(v1 2025 年 6 月 6 日,v3 2025 年 10 月 20 日);十种方法、两类任务、各三个领域:arxiv.org/abs/2506.11097
常见问题

你想知道的,都在这里。

要多久才能出现在 AI 搜索结果里?

技术层面的可见性修复,随重新抓取生效,通常几天。被引用则慢得多也更嘈杂,因为同一个问题在不同运行之间答案本就会变。合理预期是:一周内完成机制修复,两周内建立基线,固定提示集重复跑至少三轮后才读方向。

要出现在 AI 搜索结果里,必须做结构化数据吗?

不必。Google 自己的指南写明:生成式 AI 搜索并不要求结构化数据,也没有需要额外添加的专用 schema.org 标记。标记对那些真正消费它的搜索功能仍然有用,所以把它当成低预算的解析卫生工作,而不是影响引用的杠杆。

屏蔽 GPTBot 会把我从 ChatGPT 搜索里移除吗?

不会。OpenAI 的文档为不同任务分列了不同的 token:GPTBot 抓取的是可能用于训练基础模型的内容,而 OAI-SearchBot 才是把站点呈现在 ChatGPT 搜索功能里的那一个。屏蔽前者是授权决定,屏蔽后者才会让你从那些答案里消失。

有没有工具能保证 AI 引擎引用我的品牌?

没有;声称能做到的厂商,描述的是至今无人验证过的东西。该领域已发表的综述给出的结论是:被审阅的技术里,没有任何一种展示出跨平台、可持续的因果效应。可以买到的,是更快的测量,以及更快地供给答案可能取用的那些文档。

Bavior 编辑部

负责调研与维护 Bavior 关于 Reddit 营销和 AI 搜索可见度的全部内容。文中每一个数字都注明了来源出处与核查日期,所有外链均非联盟推广链接。

发现数字有误?告诉我们,我们会重新核查:support@bavior.com

你没法把一块仪表盘发布进 AI 答案里。
先找出你的品类究竟是从哪些页面和帖子被引用的。

免费试用