1 从被引用的 URL 出发,而不是从子版块体量出发 写下买家真的会敲进去的十个问题,在你在意的每个引擎上各跑一遍,把答案引用的每一个 URL 都记下来。这份通常接近十五个 URL 的清单,就是你的工作集。
2 先读帖子,再读子版块 按顺序核三件事:这条帖子是否还开放回复;它提的问题你能不能用具体的东西来回答;以及这个子版块是否允许一个有商业利益的人回复。
3 回答那个被提出来的问题 一条会被引述的回复里,含有一个约束、一个数字和一条边界:你测了什么、在什么上面测的、以及它从哪里开始不再成立。而读起来像是在站位的那个版本,会先被版主删掉。
4 在社区要求披露的地方就披露关系 凡是子版块或平台要求披露商业关联的地方,披露都是必须的;这项义务不会因为受众里现在多了一套检索系统就变轻。
5 把同一组 prompt 再跑一遍,盯着集合移动 引用集合并不稳定,所以三月里承载了某条答案的帖子,到九月可能什么也不承载。按计划重跑那组固定 prompt,并停止在已经掉出答案的帖子上投入。
第一步正是最常被跳过的一步,而跳过它是这里最昂贵的错误。按体量挑社区,产出的是一个人气排行;而引擎检索的帖子,是按“是否匹配某个问题”被选出来的,这两份名单的重合度远比所有人预期的低。在一条从未被引用过的帖子上写出一条有用的回复,换来的只是善意而没有引用,而且没有任何东西会告诉你它失败了。
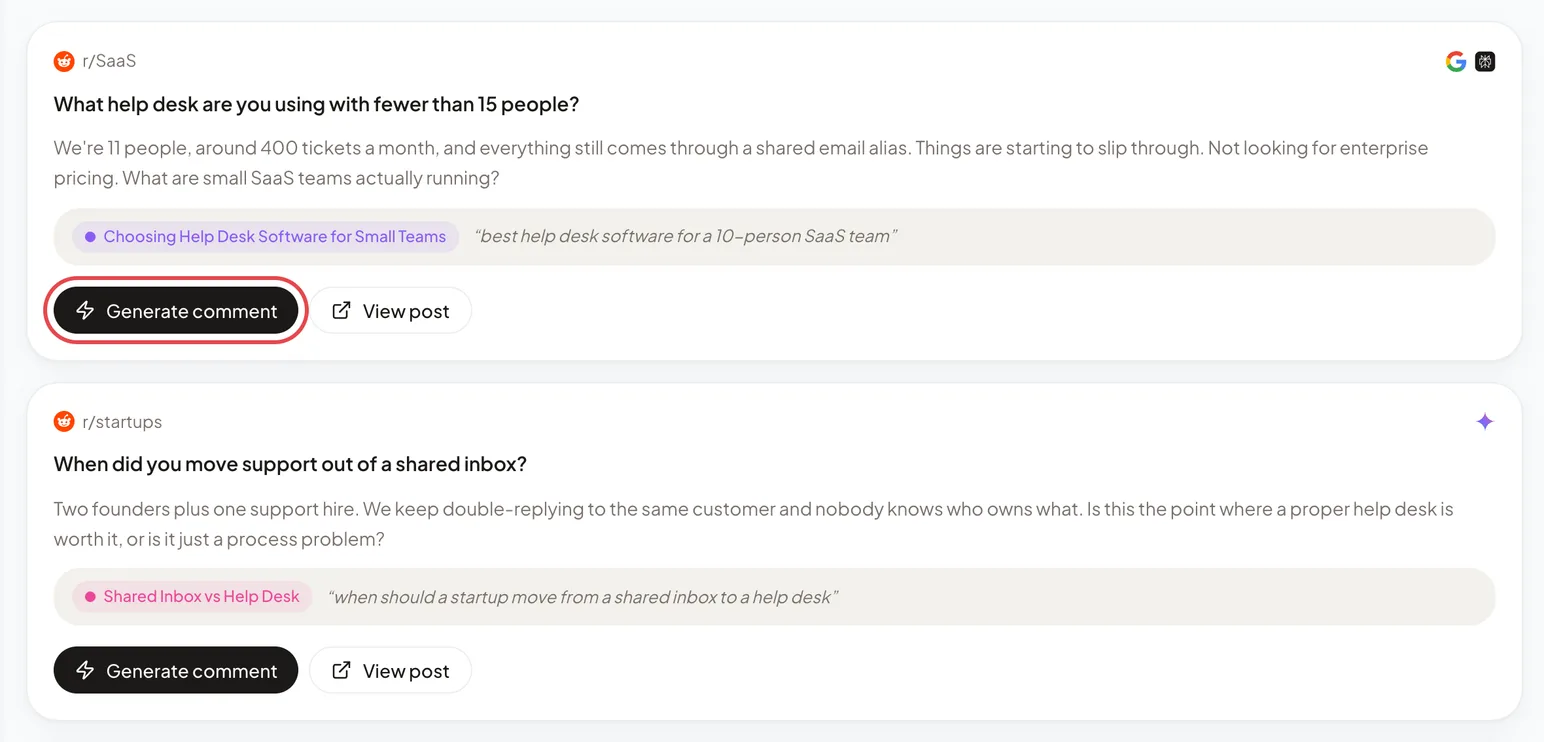
第一步和第二步手工就能做,用一张表格记下 prompt 和每条答案引用的 URL 即可;Bavior 把“找到这些帖子”和“起草并审批回复”放进同一个队列。打开 Action Opportunities :每张卡片都是一条 AI 引擎已经在引用的帖子,带着它的子版块,以及触发它的主题和 prompt。先用 View post 做第二步的核查,再点 Generate comment 。
演示工作区中的示例数据。帖子标题仅为示意,并非真实的 Reddit 帖子。红框标出的是 Generate comment,它生成的是一份等你审阅的草稿,而不是一条已发出的回复。
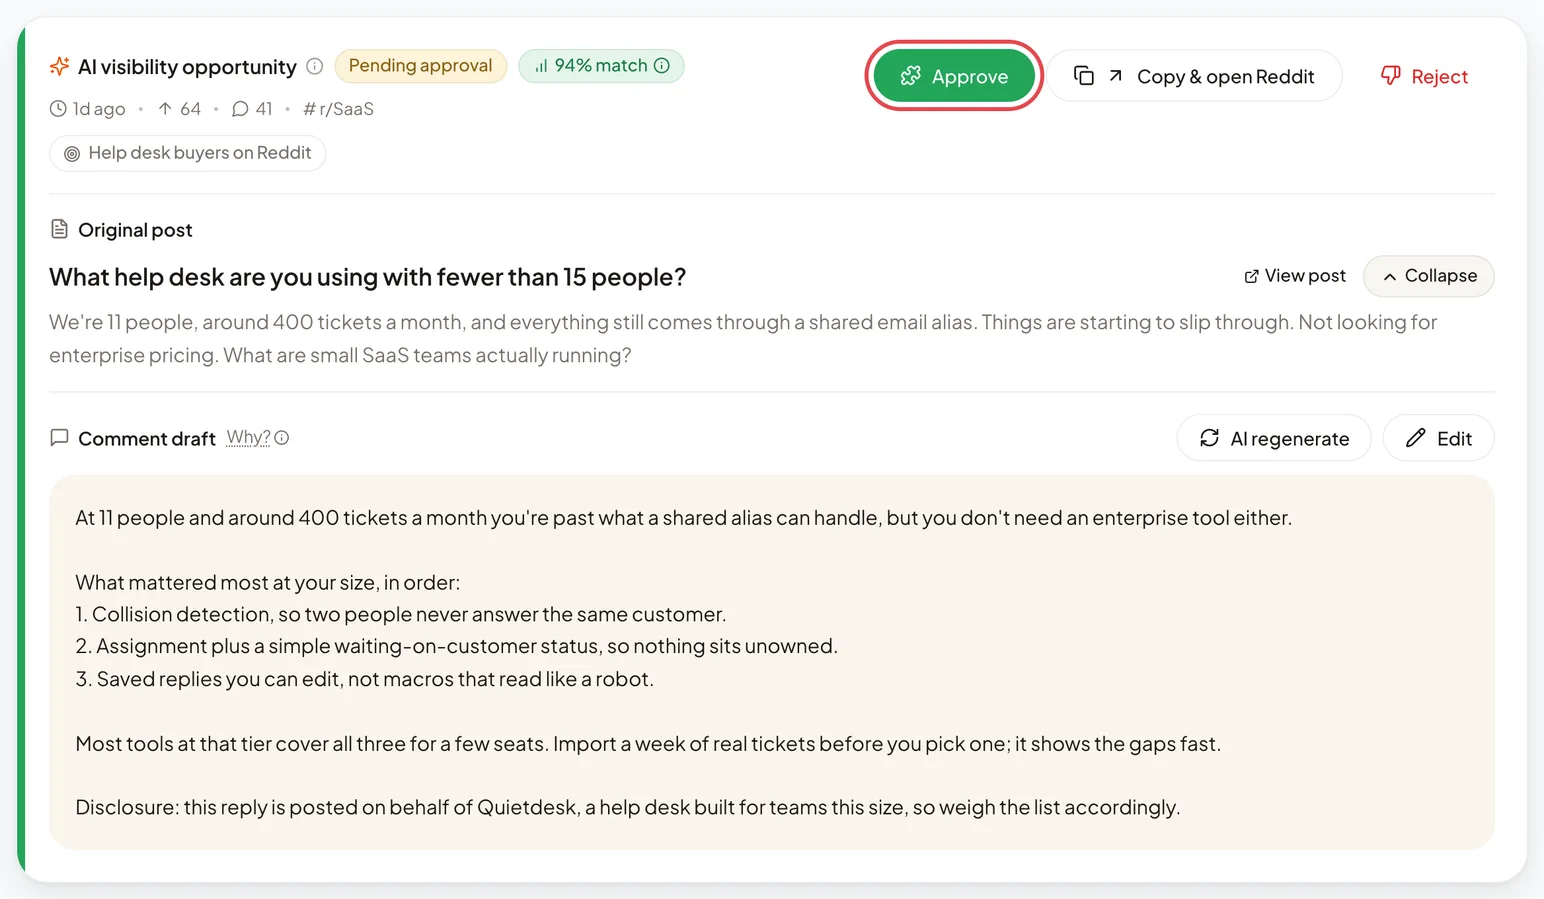
草稿会停在 Pending approval 下等待。对照第三步和第四步逐条检查:它是否在帖主给出的限制之内作答?是否按子版块的要求,披露了这条回复是代表谁发的?用 Edit 修改,直到两条都成立。点 Approve 后,由人工运营用 Bavior 提供的账号发出;Copy & open Reddit 则用于你用自己的账号发布。
演示工作区中的示例数据。帖子标题仅为示意,并非真实的 Reddit 帖子。这份草稿针对的正是上面第一张卡片里的同一条帖子;红框标出的是 Approve,没有它 Bavior 不会发出任何内容。
还有一个必须诚实交代的预期,因为这条建议的流行版本假定了它。一条被点赞的回复不会变成一次引用。它只是变成了某条帖子的一部分,而这条帖子可能会、也可能不会在你在意的某条查询上被检索到;至于引擎会不会发出那条查询,根本不由你决定。本文能够核实的研究中,没有任何一份把点赞数、评论深度或账号年龄当作引用筛选的输入来测量。